OpenAI DevDay 2026
What Comes After Loops? Deep Dive Into Agentic Architecture
Raj Bhatek、Eric Provencher · OpenAI(应用 AI / Codex DX)
agent 架构的演进:模型 + harness 联合训练(Codex)→ 把压缩(compaction)训练进模型 → 「循环工程」与 /goal(目标存在上下文之外、跨压缩持续)→ GPT-5.6 把「坚持」训练进模型 → Ultra 让 Codex 自己复制并协作 → 协调、结对、经理等 skill 组织子 agent → 跨团队交流的大规模 agent 团队(他们称在 Navier-Stokes 等问题上取得结果)。另一招:让 agent 维护一份简洁的工作日志(总目标、进行中的工作、最新指示与两者的关系)。
内容概要
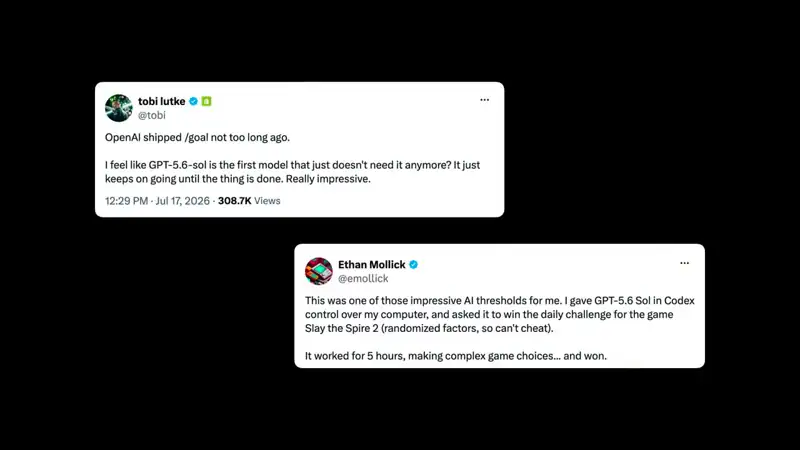
Bhatek 从 ChatGPT 写 FizzBuzz 要人复制粘贴讲起;后来是 o3 的工具使用、Deep Research,再到 Codex:模型推理和选择、调用工具、harness 提供指令、工具和执行,两者结合形成 Codex agent,而且模型被训练在这个 harness 里工作——harness 设计影响训练,训练也影响 harness。GPT-5 之后可以交出整个任务:写代码、运行、检查输出、出错自己修。上下文填满时通过 Responses API 的 /compact 压缩历史,Codex 把「被压缩后如何继续工作」训练进模型,模型知道该保留什么、删去什么。循环工程:反复运行 agent,每次新上下文,从上次的文件继续(读计划、保存进度、做下一个任务、测试);GPT-5.5 时把它带进 Codex 成为 /goal——目标由 harness 存在上下文窗口之外、不会被压缩,跟踪状态并判断 agent 是否完成,可跨多次压缩长时间运行;agent 真遇到阻塞时可以请求停止。这为训练提供了信号:GPT-5.6 把「坚持」训练进模型本身(Shopify CEO 称其为第一个不需要催促继续的模型)。Provencher 讲团队:Ultra 让 Codex 自己复制并与副本协作完成最大的任务,但每加一个 agent 都会显著增加 token 而不一定更快更好——是否需要由你判断:明显可分解的任务(评审五个 PR)直接指定每个子 agent 一个;需要广泛研究的(棘手的竞态条件)让几个子 agent 分头调查。Skills:Coordinate(把独立工作分到有明确产出和归属的并行子 agent 通道,让 agent 直接给相关 agent 发消息解决具体问题)、结对编程(生产者 + 消费者互相反馈,例如一个在旧引擎里做捕获、一个在 Blender 里解包可视化场景)、Manager(给两个对等者一个具体结果、共享约束、互补职责和初始写入划分)、Studio(持续职责:制作人、美术、设计、编程、试玩)。保持一致性:频繁追加指示后,经过三四次压缩 agent 可能偏离原始提示,让它维护一份简洁工作日志——总目标、进行中的工作、最新指示与两者的关系——又不至于变成每次失败测试的流水账;「最佳实践有保质期,别依恋你的工作流」。结尾:agent 团队——多个团队用不同方式解同一问题、团队内有子 agent、团队之间可以交流以避免重复(1 万个 agent 做同一件事非常贵),随着发现创建、重组团队,但目标不变;他们称内部比 GPT-6 更强的模型用这种模式在 Navier-Stokes 上取得结果,并解决了 100 多个长期数学问题。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 2:52
Codex agent = 模型(推理与选择)+ harness(指令、工具、执行),模型被训练在 harness 里工作;harness 设计影响训练,训练也影响 harness。
- 6:00
上下文填满时调用 Responses API 的 /compact;Codex 把「从压缩状态继续工作」训练进模型,模型知道保留什么、删去什么。
- 7:50
循环工程:反复运行 agent,每次新上下文,从上次的文件继续(读计划→存进度→下一个任务→测试)。GPT-5.5 时成为 /goal:目标存在上下文之外、不会被压缩,跨多次压缩持续工作。
- 9:00
GPT-5.6 把「坚持」训练进模型:理解有用的步骤、自查工作,不再需要「继续」的催促;真遇阻塞会请求停止。
- 11:57
Ultra:Codex 自己复制并与副本协作;但每个新 agent 都显著增加 token,不一定更快更好——明显可分解的任务(评审 5 个 PR)显式分派,需要广泛调查的让几个子 agent 分头查。
- 14:04
Coordinate skill:把独立工作分到有明确产出和归属的并行通道,agent 之间直接发消息解决具体问题;Manager skill:给两个对等者一个具体结果、共享约束、互补职责和初始写入划分。
- 14:36
结对子 agent(生产者 + 消费者):一个在旧引擎做捕获,一个在 Blender 解包场景,互相影响格式与优化;需要明确定义通信边界。
- 18:25
多次压缩后 agent 会偏离原始提示:让它维护简洁的工作日志——总目标、进行中的工作、最新指示与两者的关系;「最佳实践有保质期」。
- 20:56
agent 团队:多个团队以不同思路追同一目标,团队间交流以避免重复(1 万个 agent 做同一件事很贵),随发现重组团队但目标不变;他们称内部模型用此模式在 Navier-Stokes 上取得结果并解决 100 多个长期数学问题。
可以用在日常工作里的
- agent
长任务把目标和计划存放在上下文之外(goal 文件、计划文件),每轮从文件恢复;让 agent 维护简洁的工作日志。
- agent
多 agent 不是越多越好:只在任务可分解或需要多方向探索时才分派,并明确归属与通信边界。