AI Engineer World's Fair 2026
How We Solved Agent Building
Andrew Qu · Vercel
Vercel 内部数据 agent 的四次重写:大提示塞 schema → 分段 agent 链(只传摘要,无法回头修错)→ 单个有状态 agent → 沙箱文件系统 + bash 探索语义层;再用定时任务把常见查询提炼成约 100 个 skills,最后沉淀为文件约定式框架 Eve。
内容概要
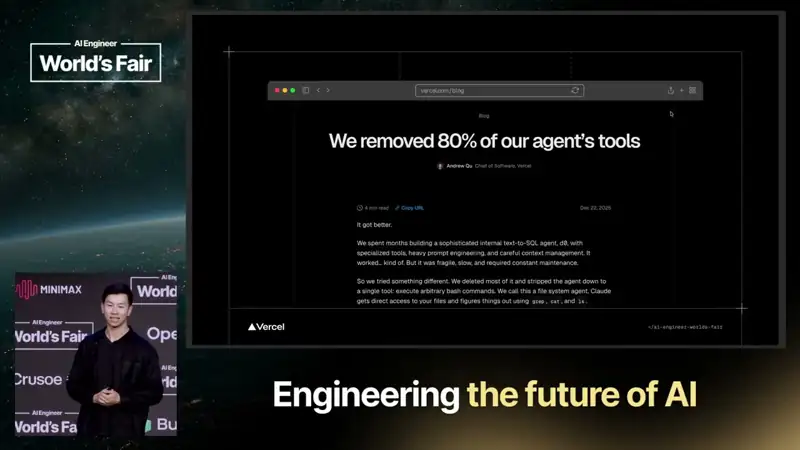
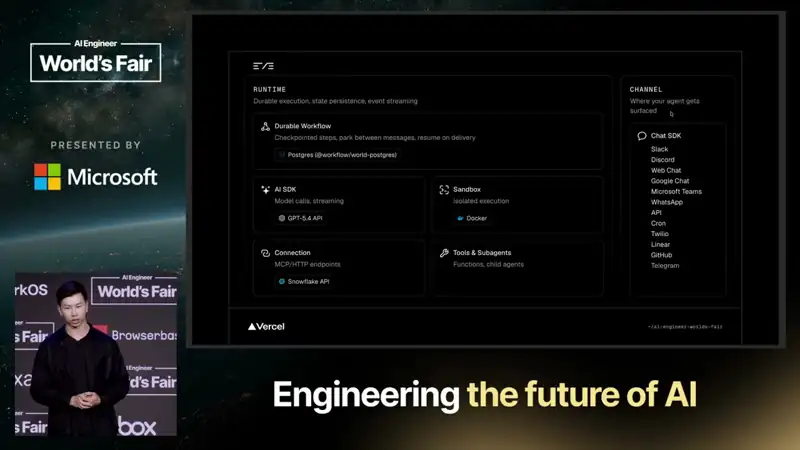
目标是「每张桌上一个 agent」,落到实际:让数据团队不再是瓶颈。第一版把 Snowflake schema 塞进大系统提示,模型给 SQL,人复制去跑,用来证明能力。完整流程需要理解问题、探索语义层、写 SQL、执行、修正、解释,于是做了分段 agent 链,但每个下游 agent 只拿到上游的摘要和片段,执行时发现 join 错了也无法回头重新探索。改成一个在规划、构建、执行、汇报间切换、保留全部工作上下文的 agent(上限约 100 步)。后来发现 Claude Code + Opus 4.5 能答对许多自研 agent 答不对的问题,原因在于普通环境:一个文件系统加上列文件、读文件、跑 bash 的最小操作集,模型对这些非常熟悉;于是把语义层放进沙箱文件系统让 agent 自己探索。每天数千次查询中大量形状相似,定时任务把近期查询提炼为约 100 个聚合与查找类 skills。最终把模式做成 Eve 框架:像 Next.js 的文件约定一样,用 skills、tools、channels 文件夹声明 agent;但决定 agent 是否有用的仍是公司知识。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
Agent 基础设施:AI SDK 提供跨模型提供商的统一接口(换模型从改三四百行变成改一行),再加上模型回退、安全执行、持久化和可恢复。
- 3:46
第一个原型:把 Snowflake schema 整个放进大系统提示,模型返回 SQL,由他手动复制到数据库界面执行——先测一个小能力,再自动化周边流程。
- 4:40
有用的答案需要多种工作:理解问题、检查语义层、找到相关表和关系、写并执行 SQL、根据结果修正、解释结果。
- 5:47
分段 agent 链只把摘要和小片段传给下游,执行时暴露的错误(例如 join 关系错了)无法回溯到探索阶段。改为一个 agent 在规划、构建、执行、汇报之间切换并保留完整上下文,最多约 100 步。
- 7:48
Claude Code + Opus 4.5 能答对很多自研 agent 答不对的问题。他认为优势来自普通环境:一个文件系统和最小操作集(列文件、读文件、跑 bash),模型在这些操作上训练充分,可以自由探索并写中间结果,而不必每个发现都通过专门工具。
- 9:06
重写为沙箱文件系统方案:语义层以文件形式放进沙箱供 agent 搜索,配合少量 Vercel 专用工具,评测结果提升。
- 10:17
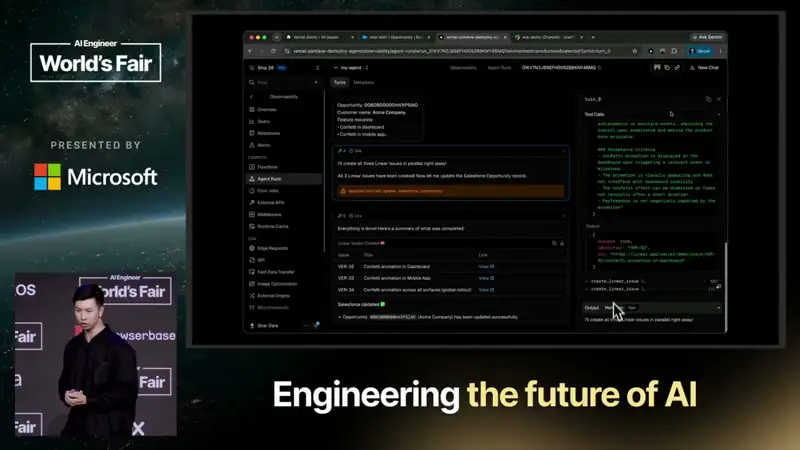
每天数千次查询里大量问题形状相同(客户指标、销售指标、npm 下载量、产品查询、账单)。一个定时任务把近期查询提炼成 skills,约 100 个,覆盖聚合与特定查找;新的运行在语义层和系统提示之外,还带着已有工作沉淀的上下文。
- 12:09
Eve 框架:类比 Next.js 的文件约定,用 skills、tools、channels 文件夹声明 agent 的知识、能力和交互方式,由框架组装;演讲前两周发布,提供可克隆的模板。
- 15:30
Vercel 也测过能连 Snowflake 跑查询的垂直 agent,自研 agent 的差异化在于公司特有知识(例如客户拥有网站和 Web 资产、实体之间如何关联、何时该查什么);语义层和可复用流程因此至关重要。
可以用在日常工作里的
- Agent
多阶段 agent 不要只传摘要:让同一个 agent 保留完整上下文以便回溯修错,或者把中间产物写成文件供后续阶段查阅。
- 数据
把语义层/数据字典做成文件放进沙箱,让 agent 用 ls/grep/cat 自己探索,比写一堆专用查询工具更有效。
- 上下文
定期从高频查询或会话中自动提炼 skills,让下一次运行带着团队经验开始。