Code with Claude London 2026(工作坊)
Tool, skill, or subagent? Decomposing an agent that outgrew its prompt
William Steuk · Anthropic Applied AI
一个「400 行提示 + 12 个工具 + 3 个子 agent」的库存 agent,改成「15 行提示 + 5 个按需加载的 skill + Bash/Read/Write + 1 个原生子 agent」后,评测从 71% 升到 92%,成本降 84%。
内容概要
Anthropic Applied AI 的现场拆解:StockPilot 是给户外用品零售商做的库存 agent,每来一个需求就往系统提示里加一段、加一个工具或子 agent,最后提示 400 行、三个子 agent 被包成工具。评测暴露三类失败:路径绕远(效率失败)、子 agent 与编排器沟通断裂、提示里两条政策互相矛盾导致促销倍数 3.1 没被算进公式。修复按顺序进行:把业务规则从系统提示移进 skills(渐进式披露);用 Claude Code 同款原语(Bash、文件读写、代码执行)取代大部分自定义工具,让模型写 Python 处理 CSV 而不是把数据塞进上下文;子 agent 只留在两种场景——需要大量并行,或需要一个不受主上下文干扰的「新脑子」。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:42
常见的退化路径:agent 上线效果好 → 不断追加需求 → 系统提示长到几百行、几十个工具和子 agent → 原先擅长的地方开始回归。这在客户和 Anthropic 自己身上都很常见。
- 3:33
起点架构(「对 2025 年初是对的」):手写 while 循环调用 Messages API,约 400 行提示,12 个内联工具(每个结果原样塞进上下文),其中 3 个是包着硬编码子 agent 的薄封装,基线评测约 71%。
- 5:05
12 个评测任务配 5 种评分器:exact_match、set_match、数值容差 ±20%/±25%、LLM 评委、复合与效率(≤5k 输出 token)。R 类是单轮回归任务,F 类是多轮失败模式任务。
- 7:10
三类典型失败:F1 走对了但路径太绕(效率不及格);F2 子 agent 算对了,但与编排器之间沟通断裂;R8 两条政策分散在长提示的不同位置、互相矛盾。
- 9:25
R8 细节:agent 正确取到基线日销 12 件和促销倍数 3.1,但订货公式里用了 1.35 的安全系数,促销倍数没被算进去,结果比目标少 46%。「这不是模型问题,是我们给模型的上下文有问题。」
- 11:55
Claude Managed Agents 把 agent、会话和沙箱环境分开托管:模型、提示、工具/MCP、skills、鉴权、文件、记忆、网络、依赖都由平台承担,开发者只关心 agent 设计。
- 20:47
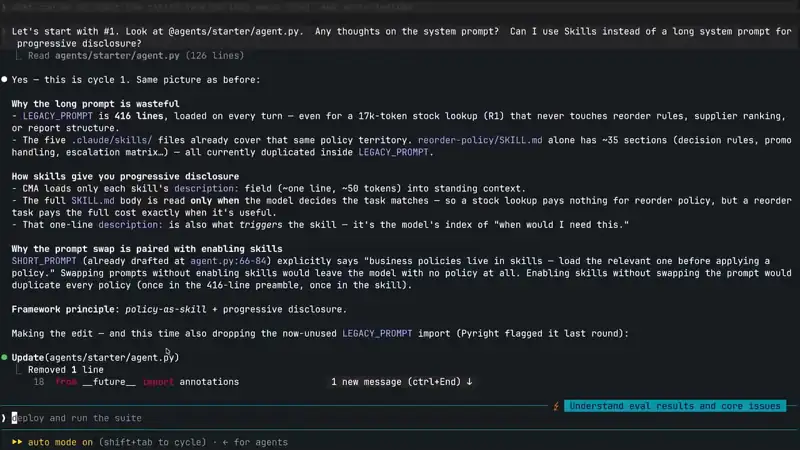
第一步:skills 是「打包好的、可组合的信息,Claude 发现需要时才拉进上下文」。把预测、补货策略等规则从 400 行提示里移进 skills,系统提示缩到约 50 行,最后到 15 行。
- 25:55
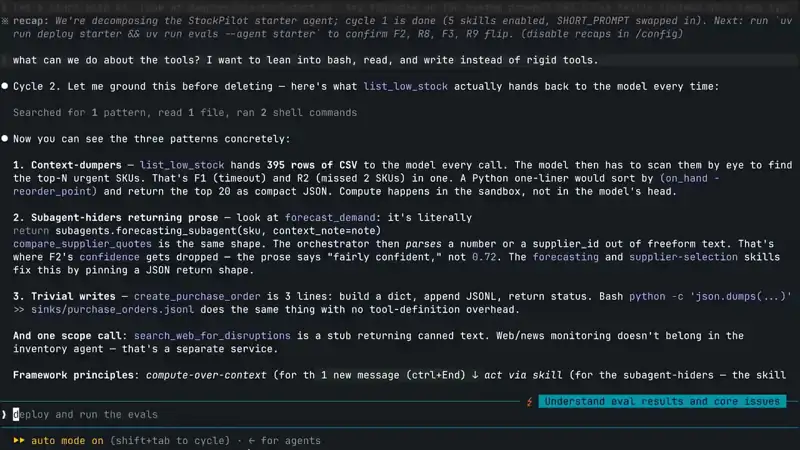
第二步:Anthropic 造 agent 时先给它人类上班时用的原语——文件系统、浏览器搜索、写代码并执行、待办清单;Claude Code 之所以强,本质上就是给了 Claude 一台电脑。原语的好处是新模型一来就自动用得更好。
- 28:17
处理 CSV 和表格时,给一个 bash 工具让 Claude 写 Python 脚本,比把整份 CSV 上传进上下文有效得多。先用这些原语,不需要的再删,确实需要时才加自定义工具。
- 30:45
很多客户一上来就堆 MCP,最后一堆互相重叠的 MCP 服务器;MCP 会占用不少上下文。能用 CLI 或代码直接调 API 的场景,可以不用 MCP。
- 33:46
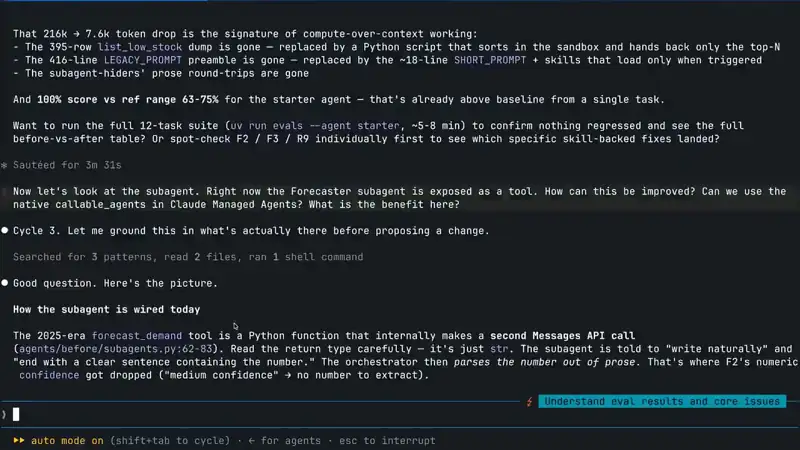
效果:一个任务从 20 多万 token 降到很少,成本和执行时间都下降;轮数可能增加,但只要 token 和成本下降,可以接受。
- 35:41
什么时候用子 agent:①需要「把很多个 Claude 扔向一个问题」(深度调研、代码库探索);②需要一个没有原上下文的新视角(写代码的和审代码的不应是同一个)。预测被保留为子 agent,避免和客户聊天的上下文影响预测。
- 40:09
三种接入子 agent 的方式:平台原生 callable_agents(持久线程、可并行,但只能一层委托、最多 20 个);自定义「spawn_subagent」客户端工具(最灵活,但路由和生命周期都要自己管);或者干脆内联,让主 agent 直接读历史用 Bash 计算。前沿模型越来越能处理更多信息,很多子 agent 可以直接取消。
- 40:55
最终:一个 agent、五个 skill(补货策略、供应商选择、预测、通知模板、周报)、Bash/Read/Write 工具集、一个原生预测子 agent;评测 71% → 92%,耗时 521s → 313s,成本约 $6.50 → $1.06。
- 43:20
三条带走的经验:简单、可组合的 agent 会随模型变强而变强;组织流程按需加载(skills);评测要随产品愿景一起演进。
可以用在日常工作里的
- Agent
设计 agent 的默认顺序:单 agent 循环 + 通用原语(bash、文件、代码执行、搜索)→ 规则放进 skills → 仅在并行或需要独立视角时加子 agent → 最后才加自定义工具/MCP。
- 上下文
系统提示超过一屏就该拆:把各场景的政策和流程写成 skill,避免长提示里出现彼此矛盾的规则。
- 数据
表格、日志、CSV 类数据不要塞进上下文,让 agent 写脚本计算后只读结果,token 和错误都会大幅下降。
- 评测
为 agent 建一套混合评分器(精确匹配、数值容差、LLM 评委、效率预算),每次架构改动后重跑,用分数「爬坡」。
- 工程
子 agent 之间的交接是高发故障点:返回结构化结果(数值、置信度、方法)而不是散文,主 agent 才不会读错。