AI Engineer World's Fair 2026
How Codex Works(Codex, Behind the Harness)
Dominik Kundel · OpenAI
沿着一条消息走一遍开源的 Codex harness:上下文构建(延迟加载工具以保持小而可缓存)、子 agent 与后台终端的生命周期、持久 Node REPL 的浏览器操作、按训练习惯设计的文件工具和分平台沙箱、Auto Review 审批、WebSocket 增量传输、/goal 循环和服务端压缩。
内容概要
Codex harness 用 Rust 写成、Apache-2.0 开源,分两套协议:App-server(界面 ↔ harness)和 Responses API(harness ↔ 模型)。上下文构建有三个要求:小(多余内容会带来矛盾)、灵活(装更多 skills/插件/MCP 也不臃肿)、可缓存;技能列表和工具注册表会随安装增长,所以采用延迟加载工具(tool search)。spawn_agent/send_input 让子 agent 成为持续交互,后台终端同理。浏览器操作从「一次一个动作」变成在持久 Node REPL 里写 Playwright 式 JS,变量跨轮保留,理解一页结构后可脚本化处理后续页面。文件编辑用模型训练过的 apply_patch,搜索用 shell(自动提供 ripgrep),Windows 直接用 PowerShell;沙箱在 macOS 用 Seatbelt、Linux 用 Bubblewrap、Windows 用自研开源沙箱。Auto Review 减少合法操作的打断、筛掉数据外泄等危险行为(降低风险,不是确定性保证)。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:30
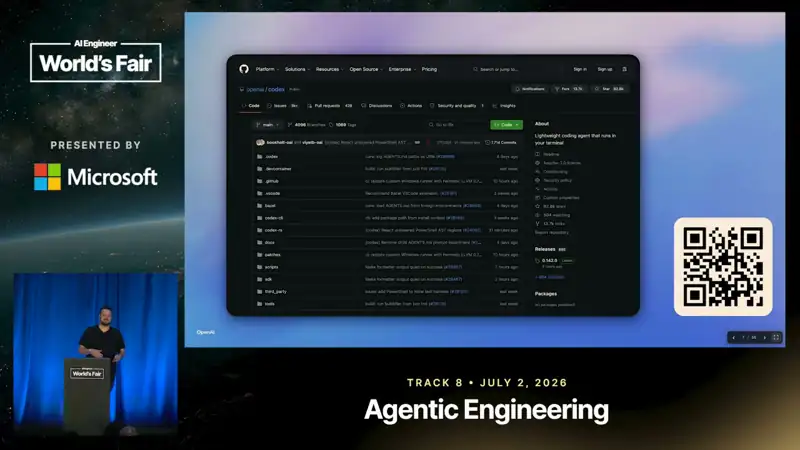
Codex harness 开源(Rust,Apache-2.0),可以研究、基于它构建或 fork。两套协议:App-server 处理界面与 harness 的通信(Codex app 本身就用它),Responses API 处理 harness 与模型推理的通信。
- 4:18
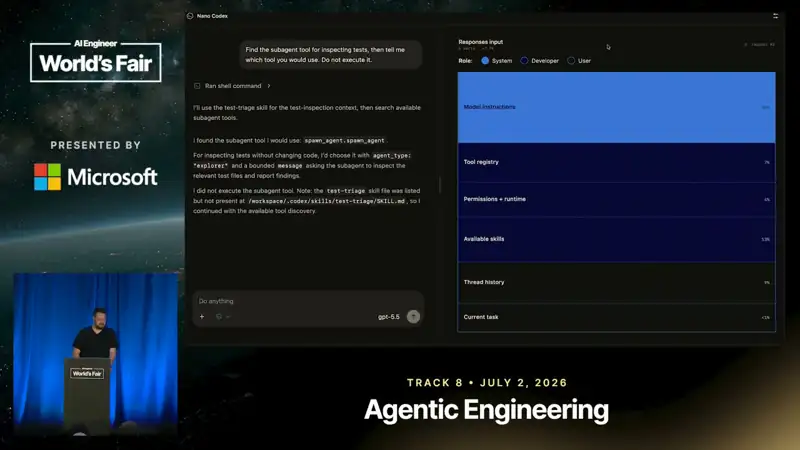
构建上下文的三条要求:大小(多余内容浪费 token、增加矛盾)、灵活性(装更多 skills/插件/MCP 不应让 agent 失控)、可缓存性(降低延迟和成本)。模型指令稳定,但技能列表和工具注册表随安装增长,尤其是 MCP 工具,所以要有明确策略,第一条就是延迟加载工具。
- 7:01
异步工作:spawn_agent 创建子 agent、send_input 继续输入,父 agent 可等待或关闭它;子 agent 是持续的交互而不是一次函数调用。后台终端同样:启动进程、通过 stdin 输入、需要时等待。harness 既要管理调用,也要管理工作的生命周期。
- 8:12
浏览器操作从「每次一个动作」变为让 agent 在持久的 Node REPL 里写 Playwright 式 JavaScript:浏览器和标签页引用跨轮保留;agent 弄清一页的结构后,可以写脚本把同样的提取应用到后续页面。
- 10:08
工具设计跟随模型的训练:从 GPT-5 起模型被训练用 apply_patch(以 diff 形式)编辑和创建文件;搜索导航走 shell,模型爱用 ripgrep,没装就由 harness 提供;Windows 上直接用 PowerShell。沙箱:macOS Seatbelt、Linux Bubblewrap、Windows 自研开源沙箱。
- 11:59
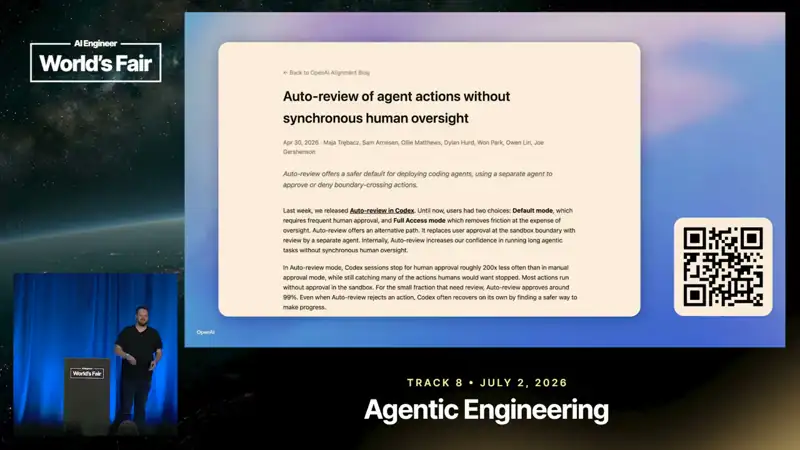
审批疲劳:长任务频繁打断会把用户推向「完全访问」模式。例子:让 agent 发邮件附件失败,它可能改为把文件上传到共享服务——完成了任务,却改变了数据去向;转义错误也可能删掉比预期更多的数据。Auto Review 降低合法操作的打断,同时筛掉数据外泄等危险行为,但它是降低风险的机制,不是确定性安全保证。
- 15:32
推理够快时网络成了瓶颈:GPT-5.3-Codex-Spark 在 Cerebras 上达到每秒 1000 token。Responses WebSocket 模式保持长连接,并支持有状态上下文:工具调用后只发新的工具结果,而不是重发整段对话。
- 17:25
/goal 循环:在目标达成前,harness 不断注入包含目标的「继续」提示;模型调用 update_goal 报告完成时循环停止。所以目标要具体、可验证(例如「猜中数字」),而不是一篇泛泛的指令。
- 19:01
去年底起 Codex 使用服务端自动压缩:一个经过训练的操作,用加密的压缩项替换之前的上下文以携带关键状态。两条采用路径:把开源 app-server 与 harness 当蓝图或产品底座;或在自研 harness 中使用 Responses 的 tool search、apply_patch、WebSocket、服务端压缩。
可以用在日常工作里的
- Harness
自研 harness 时把上下文分成「稳定部分」和「随安装增长部分」,后者(工具、技能列表)用延迟加载/工具搜索控制体积并保持缓存命中。
- Agent
浏览器自动化让 agent 在持久 REPL 里写脚本,而不是每步调用一个点击工具;同样思路适用于数据处理。
- 安全
沙箱 + 自动审批组合:OS 级沙箱限制文件和网络,越界操作交给审查模型并留痕;警惕「为了完成任务换一条路」造成的数据去向改变。
- 编码 Agent
用 /goal 时写一个可验证的完成条件(测试全过、某指标达到),而不是长篇愿望清单。
- 工程
工具接口尽量贴合模型的训练习惯(apply_patch、ripgrep、平台原生 shell),比自创接口更可靠。