AI Engineer NYC 2026
Is the Agent Harness Dead?
Jediah Katz · SpaceXAI(前 Cursor agent harness 负责人,现 Grok Bot)
编码专用的提示和护栏正在被模型吸收(数据飞轮),但 harness 没死:它转向新的前沿(长期驻留的协调者 + worker 舰队、软件工厂),而运行时、权限与安全、成本效率这三件事永远不会进权重。
内容概要
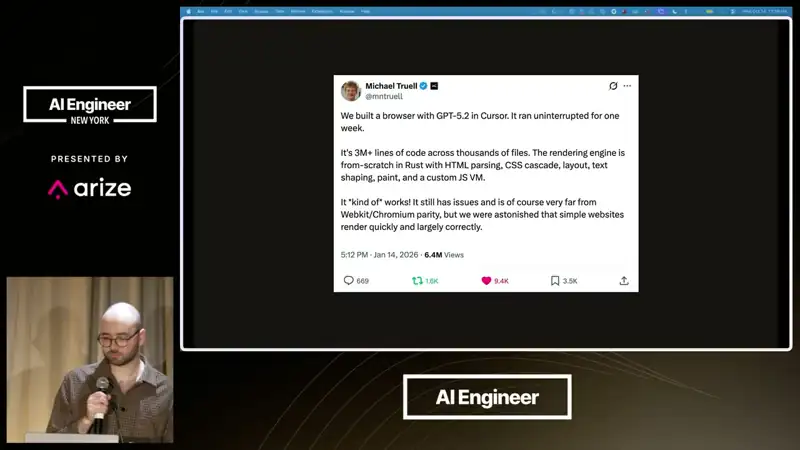
Katz 把 harness 分成两层:运行时(agent 循环在哪跑、状态怎么存以便恢复)和上下文与编排(调哪个模型、何时调、看到什么,包括提示、工具、记忆、压缩和各种行为干预)。Cursor 曾删掉很多补模型短板的干预:辅助小模型做编辑、教 agent 探索仓库和跑测试的提示等;UC Berkeley 的研究在 SWE-bench Lite 上对比 pi、Codex、Claude Code 等 harness,新模型下差异不显著。他用「数据飞轮」解释:harness 让更难的任务可用 → 更多用户尝试 → 实验室得到数据 → 模型吸收技能 → 删除旧脚手架 → harness 去开拓下一个前沿。Grok Bot 就是新前沿:长期存在的协调者 bot 指挥 worker 舰队,又需要新的提示与护栏(网页工作流、沟通频率、何时行动何时请示、记忆)。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:00
称谓演变:2023 年 prompt engineer,2025 年中 context engineer,2026 年初才有 harness engineering。harness 是模型的眼和手:包住模型、引导它、把它连到电脑和第三方服务(如 MCP)。
- 2:02
两层:运行时像传统软件工程(进程、持久化、恢复、执行环境);上下文与编排是「狂野西部」:提示、工具、记忆、压缩,以及各种让 agent 守规矩的小技巧。
- 2:59
被删掉的干预都很具体:用辅助小模型应用编辑(当时前沿模型改文件不可靠)、教 agent 探索仓库、坚持长任务、跑测试和自查的编码专用提示。UC Berkeley 研究七个前沿模型在多个 harness(含 pi、Codex、Claude Code)上的 SWE-bench Lite 成绩,新模型下 harness 差异不显著。
- 6:16
数据飞轮:harness 让更难任务可用 → 更多人用 → 实验室拿到交互数据 → 模型学会这些行为 → harness 删除旧脚手架 → 转向更难的领域。删除恰恰说明飞轮转了一圈,而不是 harness 没价值。
- 7:42
Grok Bot 改变交互单位:长期存在的协调者 bot 像律师负责策略和客户关系,把工作分给「律师助理」式的 worker 舰队。它又需要新提示和护栏,四个未解决问题:网页工作流(做幻灯片、订行程)、沟通(汇报但不刷屏)、行动还是请示(发邮件前意图是否足够清楚)、记忆(学会某个人的工作方式)。
- 10:53
软件工厂是包住多个 agent 阶段的「元 harness」:团队频道里报 bug → 自动分诊 → 云端 agent 尝试修复 → 产出前后对比视频 → 合并部署 → 另一个 agent 盯上线。更强的编码模型只改善修复这一步,事件路由、部署集成和生产监控仍要 harness 来做。
- 12:16
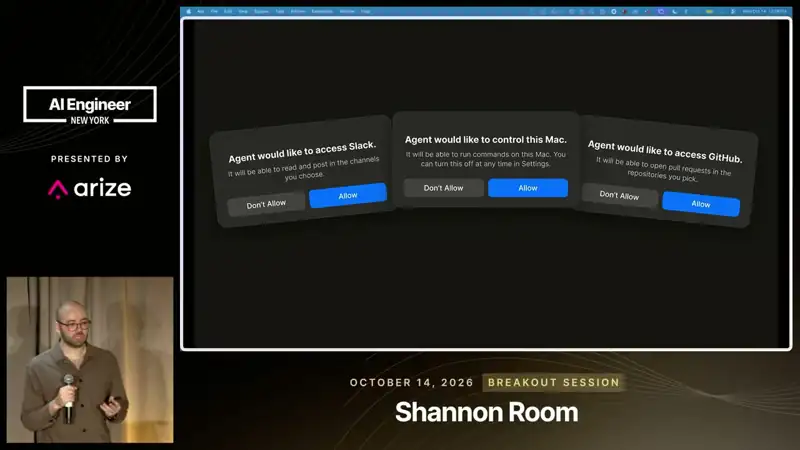
模型吸收不了的三件事:运行时(任务从分钟变成小时、天,合上的笔记本跑不了长期同事);信任与安全(「一个 shell + 一份全部密钥的文件」能刷高分,但不可接受,权限与花费上限要由 harness 强制);效率(各 harness 分数相近但每任务成本差别很大,Grok Bot 调整缓存命中率、token 效率和模型组合降本)。
- 14:18
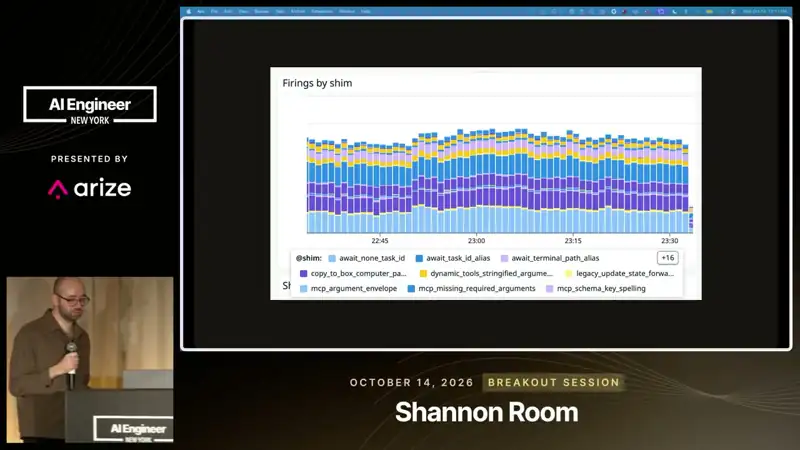
近期 harness 会先变乱再变干净,关键是可逆:功能要便宜地上线、观察、下线。少暴露内部机制给用户(Hyrum 定律),但要权衡可见性;做可复用原语而不是一次性集成,例如 subscriptions:agent 订阅 Slack 消息、CI 变红、定时等事件;临时行为补丁称为 shims,集中管理并记录,等模型学会就删。
- 16:58
harness 正在上移一层:以前组合的是 LLM 调用,现在组合的是 agent,每个子 agent 有自己的上下文、工具和循环。他预测六个月内 90% 的 agent 工作会离开笔记本,跑在云端。
可以用在日常工作里的
- Harness
把 harness 拆成「运行时」和「上下文/编排」两层分别设计;前者按传统工程标准做持久化和恢复,后者保持轻量、可删。
- Harness
为临时行为补丁(shims)建立生命周期:集中登记、记录触发次数,每次换模型时评估能否删除。
- Agent
用通用原语代替一次性集成:比如一个 subscribe(event) 工具统一接 Slack、CI、定时器等触发源。
- 基础设施
提前规划把 agent 从笔记本迁到云端:持久状态、可恢复执行、按 agent 与人限定的权限和花费上限。
- 成本
评估 harness 时除了分数还要看每任务成本:缓存命中率、token 效率和模型组合往往比换 harness 影响更大。