AI Engineer Europe 2026
Everything I Learned Training Frontier Small Models
Maxime Labonne · Liquid AI(预训练负责人)
端侧小模型(3.5 亿—240 亿参数)的设计逻辑:嵌入层别吃掉参数预算、在目标硬件上实测算子来选架构、3.5 亿参数也用 28 万亿 token 过度训练、SFT 只做很窄的任务、用偏好训练和 n-gram 重复惩罚压制「死循环」、把知识交给工具(搜索)而不是记在参数里。
内容概要
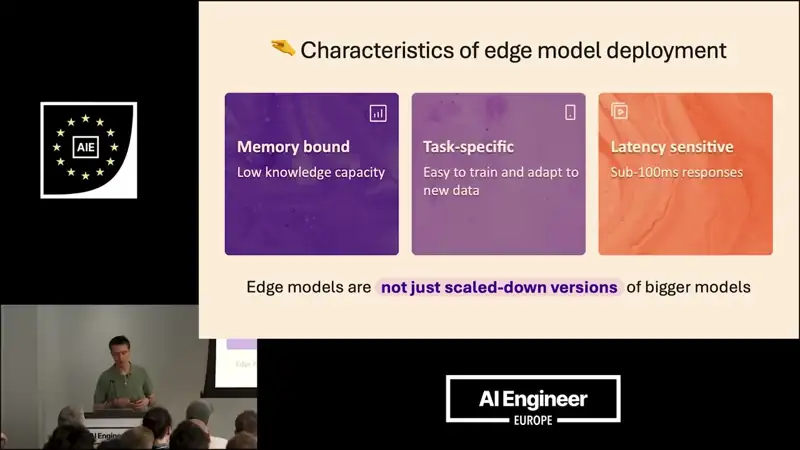
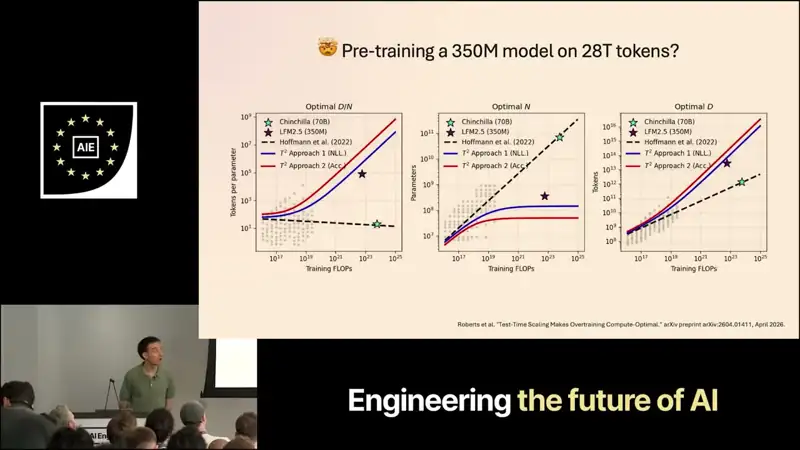
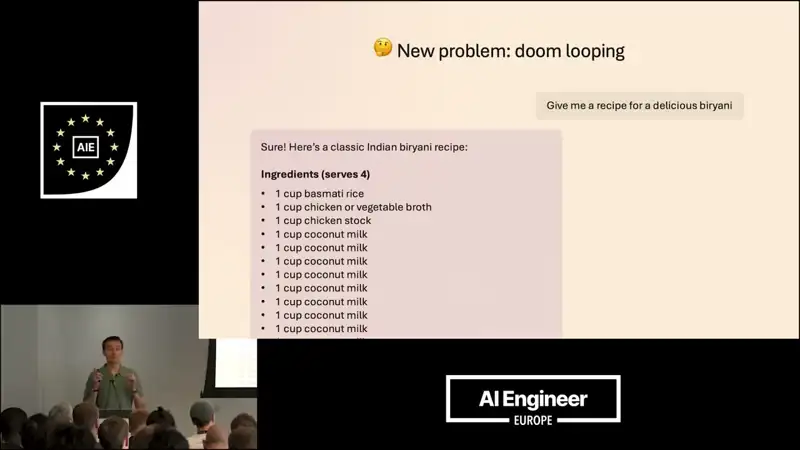
Labonne 的问题是:要在手机或车里跑的模型,应该保留什么、擅长什么?Liquid 的模型从 3.5 亿到 240 亿参数,有文本、视觉、音频版本。小模型的参数预算里,嵌入层可能占很大份额;Gemma 3 270M 用滑动窗口注意力 + GQA,Qwen3.5-0.8B 用 gated DeltaNet + gated attention;LFM2 用短卷积 + GQA,嵌入占比约 19%。架构是通过在两种目标设备上实现候选算子并实测选出来的,而不是只看理论 FLOPs。LFM2.5 训练流程是常见阶段(预训练与中期训练、SFT、偏好对齐、RL),惊人的是预算:3.5 亿参数的 LFM2.5-350M 用了 28 万亿 token(远超 Chinchilla 最优,但对推理成本主导的场景是合理的过度训练)。小模型的 SFT 要窄:例如只微调调用某个特定函数。「死循环」(无限重复一段文字)在「小模型 + 推理模式 + 任务过难」叠加时最严重:把模型自己的循环输出作为偏好训练的被拒答案,再用可验证奖励的 RL 加 n-gram 重复惩罚,奖励完成、惩罚重复。知识受容量限制,用 agentic RL 让小模型学会用网页搜索检索知识。何时用本地小模型:离线(车里不能依赖网络)、延迟、隐私与成本。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 2:28
小模型的参数预算:嵌入层可能占很大比例。Gemma 3 270M 用滑动窗口注意力 + GQA;Qwen3.5-0.8B 用 gated DeltaNet + gated attention;LFM2 用短卷积 + GQA,嵌入约占 19%。
- 3:59
在目标硬件上选算子:团队在两种目标设备上实现候选算子并做性能剖析,按实际延迟和内存选择架构。
- 6:07
LFM2.5-350M:3.5 亿参数,用 28 万亿 token 训练——远超「计算最优」的数据量,因为端侧部署的总成本主要是推理。
- 8:31
小模型的 SFT 要窄:拿一个现成模型微调去调用某一个特定函数就是很合适的目标,任务越窄越有效。
- 10:41
「死循环」:模型无限重复一段文字而不给出答案;小模型 + 推理模式 + 任务过难三个因素叠加时风险最高,不只出现在数学题里。
- 12:46
把模型自己的循环输出当作偏好训练的被拒答案;再用可验证奖励的 RL 加 n-gram 重复惩罚:抽不出最终答案的 rollout 得不到奖励。
- 15:28
把知识和上下文交给工具:容量限制了能存的知识,用 agentic RL 训练小模型调用网页搜索,把「回忆所有事实」变成「找到需要的信息」。
- 17:59
何时选本地小模型:离线运行(车不能总依赖网络)、延迟敏感、隐私与成本;蒸馏可能丢失大模型的部分能力。
可以用在日常工作里的
- 模型
垂直、窄任务(单一函数调用、抽取、分类)优先考虑微调小模型,部署在端侧或便宜的 GPU 上。
- 模型
评估小模型时专门测「重复/死循环」率,尤其是开启推理模式时。