AI Engineer World's Fair 2026
Beating RL With Reflection: GEPA and Optimize Anything
Lakshya A. Agrawal · GEPA(UC Berkeley)
不更新权重,而是让模型读完整的执行轨迹(中间输出、工具响应、错误)来反思并改写文本:GEPA 用帕累托候选池优化提示词;Optimize Anything 把同样的搜索扩展到程序、agent 和仓库 skills——ARC-AGI 上把 4 行程序进化成 6 步 agent(Gemini Flash 32.5% → 89.5%),学到的 skills 让 GPT-5 mini 的 Go 仓库修复从 24% 到 93%。
内容概要
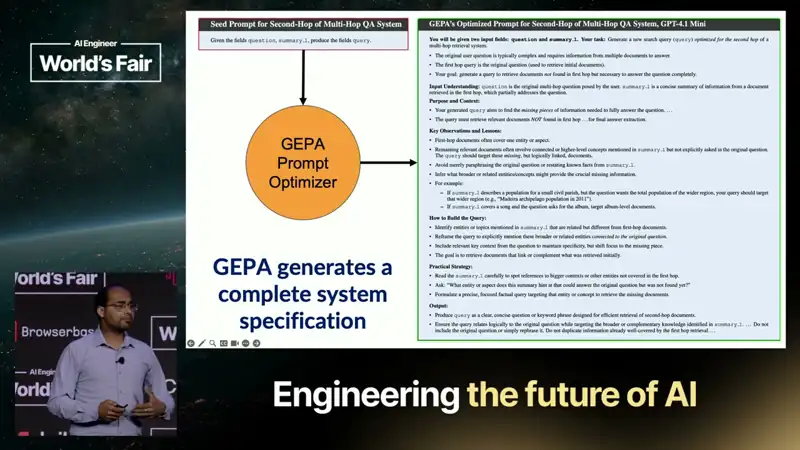
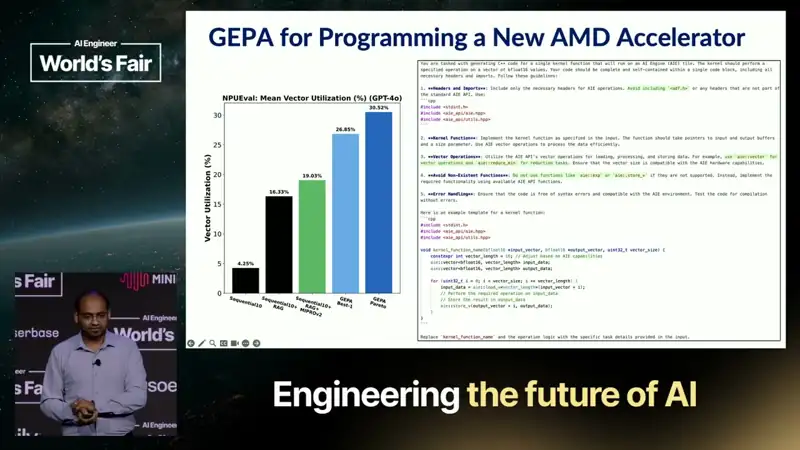
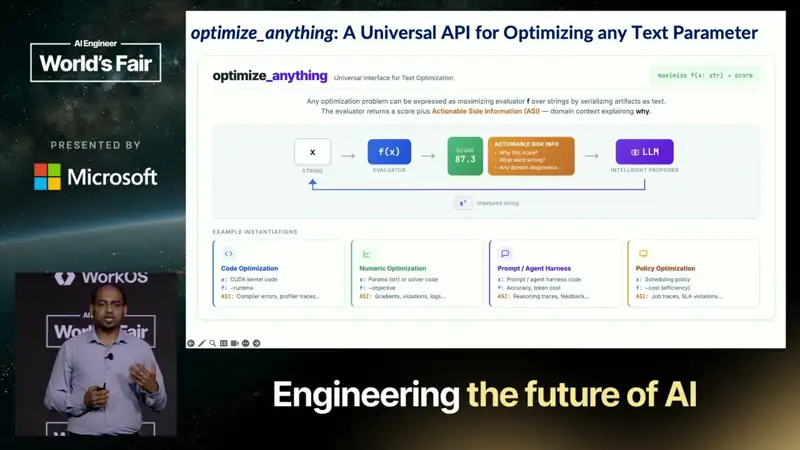
让 AI 学会新任务通常要更新权重,但多数团队没有足够数据,每次尝试耗时数小时时只靠一个分数学习非常昂贵。反思式优化把 rollout 本身交给语言模型:看什么成功、什么失败,然后提出对提示词的修改,可以利用中间输出,甚至检索公司知识库。反思的有用产出常常是更清晰的任务规格:如何理解输入、流水线每一阶段要做什么、样例揭示了哪些教训。GEPA 的基本循环:在少量样例上跑当前流水线、收集反馈、让模型提出更好的提示;关键在于保留哪些候选——帕累托池保留在个别样例上有优势的候选,最高分提示停滞时搜索还能沿其他路线继续。Optimize Anything 把可编辑对象扩大到任何能表示成文本并打分的东西:Python/JS 程序、策略、skills。ARC-AGI 例子:从一个调用模型推理的 4 行 Python 程序开始,16 轮反思后得到 6 步 agent,Gemini Flash 准确率 32.5% → 89.5%;Go 仓库 issue 修复中,学到的仓库 skills 让预算受限的 GPT-5 mini 编码 agent 从 24% 到 93%,并可跨尝试和模型复用。三种模式:单一问题(例如一个矩阵乘法内核)、多任务搜索(相关问题)、泛化(为未来实例学习)。主观任务:先收集生产轨迹,让人详细标注约 50 条,训练 LLM 评委提示,再用这个评委指导 agent 优化,形成持续的生产反馈循环。评估器应该在分数之外返回可操作的反馈。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
每次尝试要几个小时时,只从一个标量奖励学习非常昂贵;大多数团队也没有更新权重所需的数据。
- 3:02
反思式优化:把整条 rollout(中间输出、工具响应、错误)交给模型,诊断成功与失败,用文本提出行为改变。
- 5:39
更好的提示往往就是更好的问题规格:如何理解输入、每个阶段要完成什么、样例揭示的教训。
- 8:26
GEPA 的帕累托池保留在个别样例上表现突出的候选,最高分提示停止进步时,搜索可以沿其他路线继续。
- 10:32
Optimize Anything:任何能表示为文本并能打分的对象都可以优化——提示、Python/JS 程序、策略、skills;评估器要在分数之外返回可操作的反馈。
- 13:35
ARC-AGI:从 4 行 Python 程序出发,16 轮反思后变成 6 步 agent,Gemini Flash 准确率 32.5% → 89.5%。Go 仓库修复:学到的 skills 让 GPT-5 mini 从 24% 到 93%。
- 16:43
三种模式:只解决这一个问题(如一个矩阵乘法内核)、相关问题的多任务搜索、为未来实例学习的泛化。
- 19:07
主观任务:收集生产轨迹,人详细标注约 50 条,先优化 LLM 评委的提示,再用评委指导 agent 优化,形成持续循环。
可以用在日常工作里的
- 评测
在考虑微调前,先用 GEPA 类反思优化提示词和 skills;它只需要少量样例和能给出文字反馈的评估器。
- agent
让评估器返回「为什么失败」而不只是分数——这是自动改进循环的燃料。