AI Engineer World's Fair 2026
The Death of the Code Review: What the Data Actually Says
Laurie Voss · Arize AI
代码多 741%、交付只多 30%,卡在评审;人工评审有注意力上限,机器评审要靠多轮检查、一致性过滤、工具辅助调查才配得上注意力。去掉逐条审批后,人的判断转移到 harness 里,而 harness 本身也会被注入攻击;最后的评审者是生产环境。
内容概要
Laurie 用多项研究讨论「代码评审之死」。10 万+ GitHub 开发者:开 agent 后代码多 741%、交付只多 30%;Cisco 研究(10 个月、2500 次评审、320 万行):单次超过约 400 行、每小时超过 450 行,发现缺陷的能力急剧下降。OpenAI 内部实验:三名工程师从空仓库起步,五个月 agent 写了约 100 万行、合并约 1500 个 PR,评审 scaffolding 都是 agent 写的,人工评审可选。把「可合并」做成可检验的标准,就能成为训练信号(便宜可验证的东西都会被训练攻克)。机器评审已是大规模负载:GitHub Copilot 做了 6000 万次评审,占 GitHub 五分之一以上;Cursor 的评审器对每个 diff 跑 8 遍、打乱顺序、按一致性过滤。Carlini 的 C 编译器实验(16 个 agent、约 2000 次会话、能编译 Linux 内核)说明「不在回路里」不等于「不在环路上」:人搭了测试 harness。Anthropic 的自动安全评审 README 警告它没对提示注入加固;一项研究里,配上无害提交信息的漏洞代码骗过自主评审 agent 达 88%。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
10 万+ GitHub 开发者的研究:开启自主 agent 后代码量 +741%,交付的软件只 +30%,瓶颈在评审——生成改动和为改动负责是两回事。
- 3:12
Cisco 研究(10 个月、2500 次评审、320 万行代码):一次评审超过约 400 行、或速度超过每小时 450 行,发现缺陷的效果急剧下降。一个 1 万行的 agent PR 按这个速度要审一周。
- 5:13
OpenAI 内部产品实验:三名工程师、空仓库起步,五个月内 agent 写了约 100 万行、合并约 1500 个 PR,连 agent 评审的脚手架都是 agent 写的,人工评审可选,大部分评审发生在 agent 之间。
- 9:12
「便宜可验证的东西都会被攻克、被拿去训练」(编译器和测试套件让编码模型进步飞快)。如果把可维护性、范围纪律、回归安全也做成可检验的标准,就给模型训练提供了新目标,所以写 rubric 本身很有价值。
- 11:11
自动评审已是生产负载:GitHub Copilot 评审器做了 6000 万次评审,占 GitHub 评审的五分之一以上。Cursor 的经验:初版对每个 diff 跑 8 遍并打乱评审顺序(顺序会影响结果),按多次一致性过滤发现,再用工具调查和修复。
- 14:42
Carlini 的实验:16 个 agent 在约 2000 次会话中用 Rust 写出能编译 Linux 内核的 C 编译器,人没有逐个批准改动,但人搭建了评判工作的测试 harness 和反馈系统——「不在回路中」但「在环路上」。Bun 从 Zig 移植约 100 万行到 Rust,测试通过之外仍有未解决的问题。
- 17:28
OpenAI 把评审搬进执行、日志和定期清理:Codex 评审自己的改动,再调用其他 agent 评审这些评审,直到所有评审者满意;每次改动都能启动系统、让 agent 运行并检查 UI、确认 bug 是否修好,还能访问日志栈——这些是 diff 本身看不到的。
- 20:29
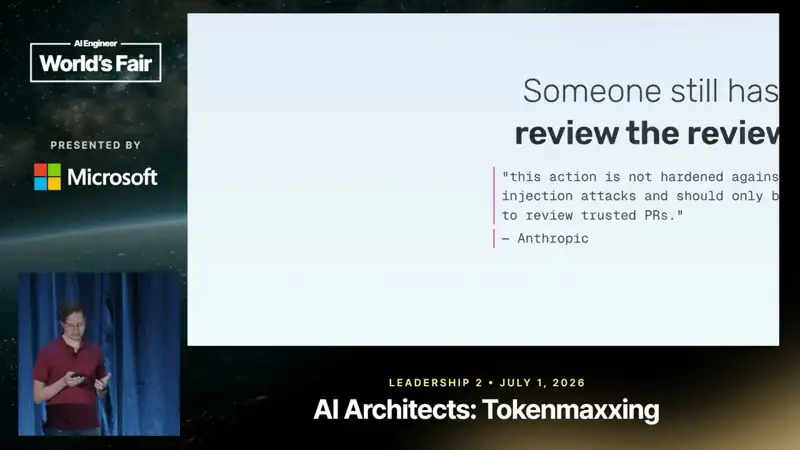
被评审的代码会影响评审者:Anthropic 自动安全评审的 README 警告它没对提示注入加固、只应评审可信 PR;一项研究中,配上看似无害提交信息的漏洞代码骗过自主评审 agent 达 88%。
- 22:00
自动化合并前评审后,生产行为是「最后一个评审者」:应观察系统在真实世界里一步步做了什么(轨迹),通过的预发布测试替代不了上线后的观察。
可以用在日常工作里的
- 质量
自动评审要设计成多轮、可复现、按一致性过滤的系统,再加工具调查(运行、看日志),而不是一次性生成评论。
- 安全
评审 agent 会被被审代码里的内容操纵:对不可信来源的 PR 不要只靠 agent 评审,评审环境与写权限隔离。
- 工程
把团队对「可合并」的标准写成 rubric(回归安全、范围、测试质量、可维护性),既用于评审也用于评测。
- 质量
上线后用轨迹和日志做持续评估,把生产当作最后一道评审。