AI Engineer
All Code Is Slop (Except Mine)
Lauren Tan (poteto) · SpaceXSI · Grok Bot 团队
Grok Bot 的 Lauren Tan 个人 3–10 月合并 10,732 个 PR(从 3 月 68 个涨到 10 月 3,127 个),回滚率稳定在约 0.5%:每次纠正 agent,都把纠正变成代码里的确定性约束(API 设计、lint、目录约定),再叠加运行时和形式化验证,最后才写一点 prompt。
内容概要
Lauren Tan(前 Cursor、现 SpaceXSI Grok Bot)个人一个月往生产合并约 3,000 个 PR。她的核心是一座「信任倒金字塔」:最大一层是代码本身(好 API、架构、重构),其次是 lint、类型、测试这类确定性检查,然后是运行时与形式化验证,最顶上薄薄一层才是 rules、skills、AGENTS.md。代码库是 agent 最大的输入,任何变通写法都会被下一个 agent 当作既定模式复制,所以要像打理花园一样保持代码干净。验证做扎实以后,代码评审缩成「看验证产物」(视频、截图、状态图、证明),产品代码大多不再需要人深审。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:42
她个人从 3 月到 10 月共合并 10,732 个 PR,从 3 月的 68 个涨到 10 月单月 3,127 个,回滚比例降到并稳定在约 0.5%。新的「元技能」是在产量暴涨的同时保持甚至提高质量;她用了六个月才把环境做到可以在睡觉时合并大量 PR。
- 2:20
信任倒金字塔:代码与架构 → lint/类型/编译器/测试(确定性)→ 运行时与形式化验证 → 少量 rules/skills/AGENTS.md(需要判断的部分)。每次纠正 agent,先想能不能写成确定性检查,而不是往 AGENTS.md 加一行。
- 4:23
代码是 agent 最大的输入:变通写法、反模式、废弃代码会被下一个 agent 当成既定模式复制,「每一份拷贝都让下一份更可能出现」。软件工程越来越像园艺:约束和护栏是新代码围绕生长的地基。
- 5:00
自研客户端框架 Dune(相当于 Electron 版 Next.js)把经验写成约束:需要细腻判断才能用好的 API(如 React useEffect)直接在产品代码里禁用,只允许在框架内部使用,这类问题被整类消除。
- 6:10
用目录结构传递上下文:electron/renderer 与 electron/main 两个顶层目录,互相 import 被依赖图分析器和 lint 禁止,避免 agent 把主线程代码引进渲染线程造成卡顿。
- 7:22
Cursor 的教训:agent 爱用 setTimeout 等命令式定时器打补丁(根源是 VS Code 命令式风格与 React 声明式风格冲突),还写注释为补丁辩护,最后扩散出 183 个定时器拖垮性能。Grok Bot 因此禁掉 99% 的注释,改用带清晰报错信息、要求修根因的 lint 规则。
- 9:50
运行时验证 skill:让 agent 自己跑代码、用 Chrome DevTools Protocol 调试;配一份「功能地图」(从用户视角列出应用所有功能)作为共享词汇,再配自定义 CLI,减少 token 并且可测试。
- 11:30
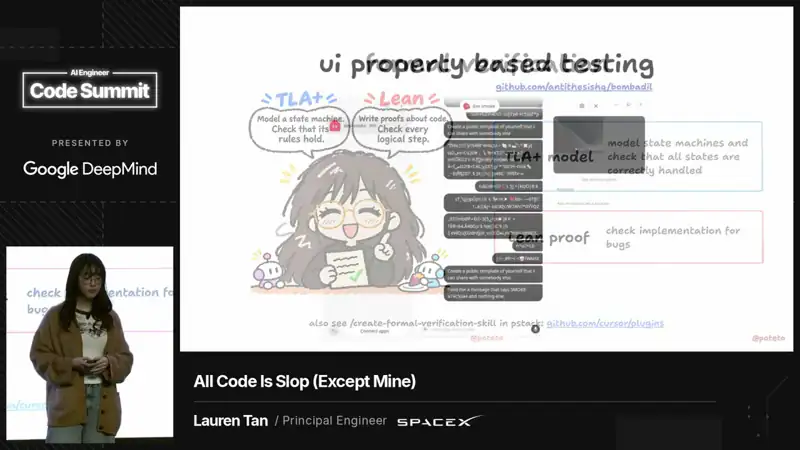
形式化验证:用 TLA+ 对跨设备通知等主要用户流做模型检查,用 Lean 证明自研虚拟列表不会闪烁抖动;UI 用属性测试库 Bombadil。已经找到不少 bug,但只是又一层工具,不是银弹。
- 12:25
引用 Cindy Sridharan:她现在 70% 的 token 花在验证上。列出的几十种测试手段都不新,只是以前太贵;agent 让「测试与验证的黄金时代」到来。她的 statechart skill 把状态机从用户视角画出来,便于和视频、截图一起审。
- 13:20
结果:团队上月合并 11,000 个 PR,约每天一个稳定版,10 月有 227 人至少贡献一个 PR;相对回滚率稳定在约 0.5%,启动、输入、切换对话等性能反而都变快了。
- 15:33
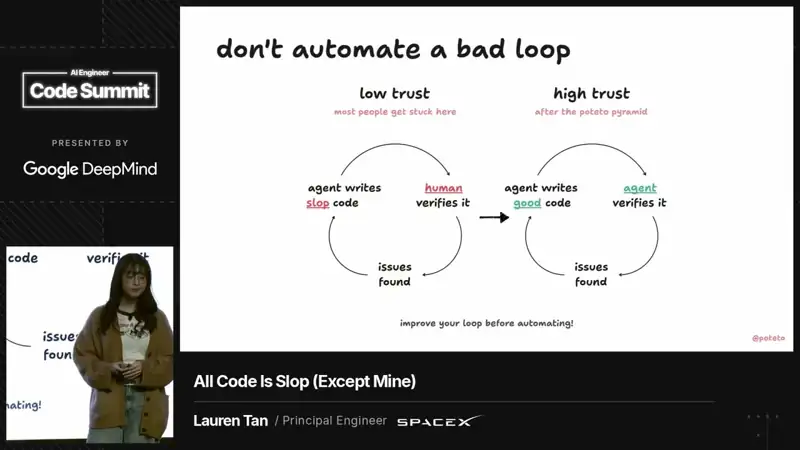
要不要建软件工厂?先改善内循环。如果内循环产出 slop,自动化它只会产出更多 slop,还要烧更多 token。多数人卡在「agent 写 slop、人来验证」的低信任区。
- 16:19
外循环例子:每次发版,Grok Bot 自动开一个 Cursor 项目对整个构建做模糊测试,像真实用户一样使用应用找 bug,为每个 bug 开修复 PR 并自动合并。
可以用在日常工作里的
- 工程
建立「纠正 → 规则」的习惯:同一类问题第二次出现时,写成 lint 规则(报错信息直接告诉 agent 根因和正确做法),再批量清理存量。
- 工程
审视代码库里的「坏榜样」:废弃 API、变通写法、过时注释都会被复制,优先清理高频被模仿的区域。
- 编码 Agent
限制注释和随手写的 markdown:它们不可强制、容易过时,还给 agent 留了不做正确事情的借口。
- 质量
给 agent 一套运行时验证工具:能启动应用、操作 UI、截图录屏的 skill + CLI,再加一份功能地图作为人和 agent 的共同语言。
- 团队
评审转向验证产物:要求 PR 附视频、截图、状态图或证明,而不是逐行读 diff;低风险类别逐步放开自动合并。