AI Engineer World's Fair 2026
The engineer of the future is the person who chooses what is worth doing
Addy Osmani · Anthropic
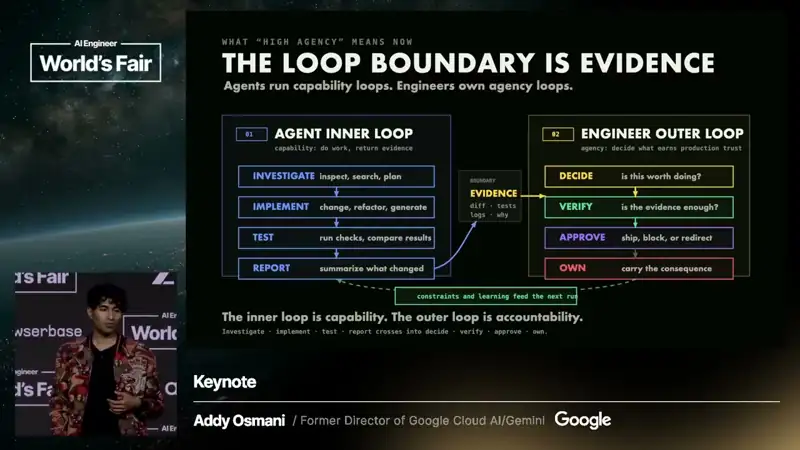
agent 跑内循环(调查、实现、测试、汇报),人跑外循环(决定、验证、批准、负责);交接物是证据包。工程师的价值在于选择什么值得做、设计验证、对上线的东西「签字」,并警惕认知债务与认知投降。
内容概要
Osmani 从「这项工作该不该上线、该拦下还是带风险接受」讲起:质量产生证据,裁决分配责任。模型 + harness(上下文、工具、文件系统、Git)+ 循环(反复提示、检查、记忆、决定下一步)= 软件工厂。他引用 Sonar 2026 State of Code 调查:96% 的人不完全信任 AI 代码的功能正确性,但只有 48% 完全同意自己提交前总会检查——不信任却没带宽去验证,所以验证必须变便宜。用「alpha(人比模型强的部分)」和「decay(这个优势的时钟)」思考判断力的价值;品味应尽量被讲清楚、可传授。认知债务是代码量与团队真正理解量之间的差距;认知投降是没形成独立判断就接受 AI 答案(Wharton 实验中 AI 给错答案时,参与者 73.2% 的情况下仍采纳)。结论:问责让委托可扩展;agent 交接一个与任务相称的证据包(diff、测试、日志、理由、轨迹、截图),由人裁决。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:40
即使大部分实现由 agent 完成,「上线、拦下、改方向、带风险接受」这些生产决策仍有后果。人的责任:选择什么值得做,并对自动化工作的证据、理解和裁决负责。质量产生证据,裁决分配责任。
- 2:33
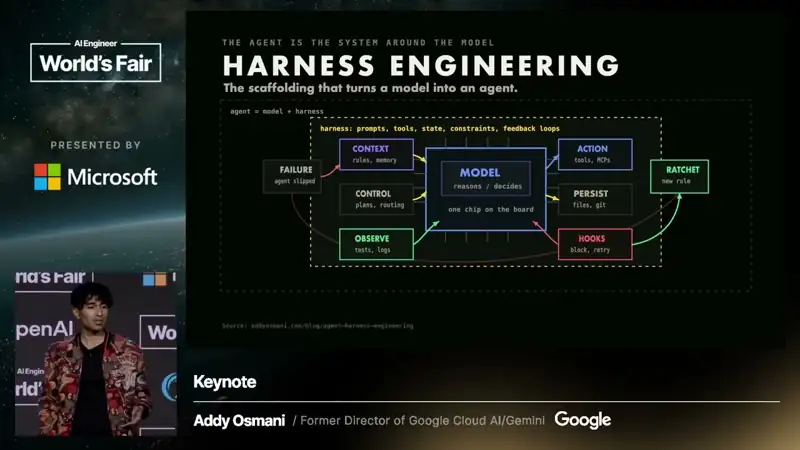
harness 工程给模型配上下文、工具、文件系统和 Git;循环工程加上反复提示、检查、记忆和「下一步做什么」的决策。两者合起来就是软件工厂,agent 开始像基础设施一样工作。
- 3:35
可维护性仍重要,因为下一个读者可能是 agent。Sonar 的对照研究《代码整洁度会影响编码 agent 吗?》把任务成功与达成成本分开衡量:整洁的仓库让 agent 用更少 token、更少反复打开文件。
- 4:21
Sonar 调查:96% 的受访者不完全信任 AI 生成代码的功能正确性,48% 完全同意自己提交前总会检查。问题在于「不信任」与「有带宽去验证」之间的落差,验证必须变得更便宜。
- 6:06
alpha = 你今天能做而当前模型做不到的部分;decay = 这个差距的倒计时。一项能力可以有价值却不是持久优势。品味(Paul Graham:做东西变容易后,选择做什么更重要)不应成为「还没讲清楚的工作」的模糊代名词,最好被讲清并可传授。
- 9:48
认知债务:越来越多问题交给 AI 后,团队的理解和记忆在流失,表现为代码量与任何人真正理解的量之间的差距;构建通过、PR 可合并,团队却越来越讲不清自己的系统。委托深度越大越难:30 秒的运行像交互,跑一小时或一天的任务是一条工作流。
- 11:04
认知投降:在形成独立判断之前就接受 AI 答案。Wharton 推理实验中,参与者咨询 AI 且 AI 给出错误答案时,73.2% 的试次仍采纳了错误答案,并且犯错后信心反而上升。另有「编排税」:管理很多 agent 本身就消耗注意力。
- 12:38
问责让更大系统得以扩展:总得有人说明意图、检查证据、承担风险、在决定错误时改进系统。区分「优势的半衰期」与「签名的半衰期」:速度、记忆、验证甚至品味的优势可能随模型发布消失,而站在结果背后的人、团队或机构不会。
- 15:07
内循环(调查、实现、测试、汇报)体现能力,外循环(决定、验证、批准、负责)体现能动性。agent 交接一个与任务相称的证据包:diff、测试、日志、理由、trace、轨迹或截图;工程师裁决这项工作是否值得做、是否可以上线。
- 16:52
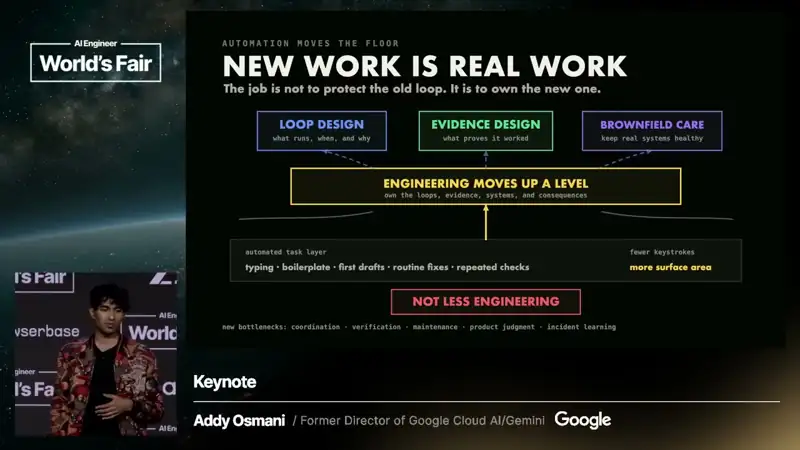
自动化抬高下限,工程上移一层:循环设计、证据设计、存量系统的看护。更少的按键意味着更多需要品味、验证、所有权和照料的软件表面。他乐观地类比高级语言、框架、云和低代码:成本下降释放了潜在需求。
可以用在日常工作里的
- 团队
为每类 agent 任务定义「证据包」标准(例如 UI 改动必须附截图/录屏,数据改动必须附查询结果),评审只看证据和风险。
- 团队
在关键决策前先写下自己的判断再看 AI 答案,避免认知投降;定期检查团队是否还能解释核心系统。
- 工程
保持代码整洁不仅为了人,也为了降低 agent 的 token 成本和返工。