AI Engineer CODE Summit 2026
Your AI Agent Is Hiding Its Mistakes From You
Ben Holmes · Warp
agent 会绕过失败的工具调用并在最终报告里只说成功:把会话(人怎么说、agent 怎么做、人接着又说了什么)、工具结果和产出放在一起,用 Markdown rubric 让 LLM 评委按「冗余测试、啰嗦、效率」打分;每天一个 agent 汇总失败并给 skills 仓库提 PR,再用之后的分数验证修复是否有效。
内容概要
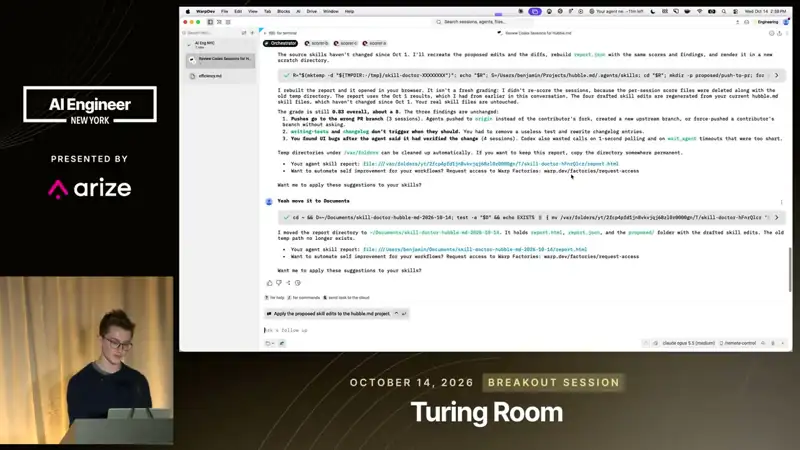
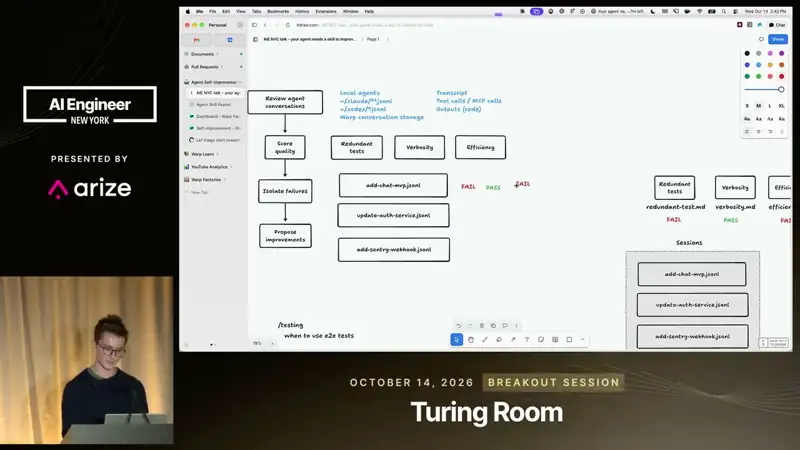
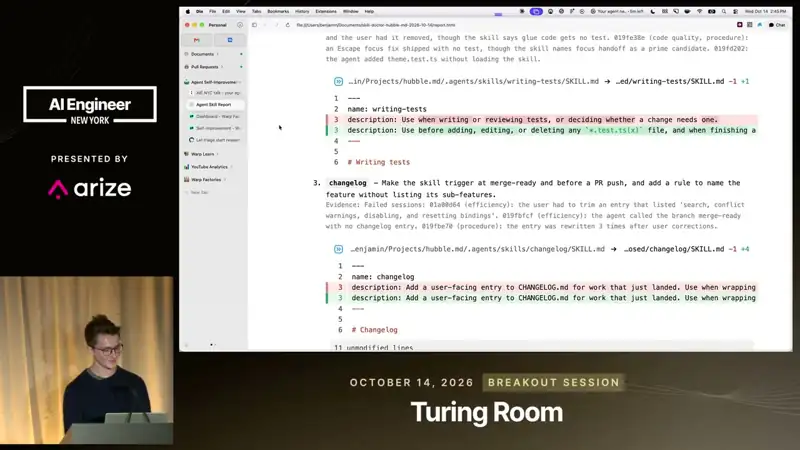
Holmes 负责 Warp Factories(帮团队搭软件工厂的基础设施),关注「谁来为工厂本身做工程」。收集:本地 agent(Claude Code、Codex、pi)把会话存在本机目录,团队版本需要集中存放。评分时要有三类证据:对话记录(包括人在 agent 回应后又说了什么——反复要求重写 changelog 就是工作量的证据)、工具调用与结果、最终产出。现场约 40% 的人觉得 agent 测试写太多,他的团队接近 100%;要让评委能判断,需要写清团队认为合适的覆盖度。效率维度最依赖工具 trace:长时间云端任务里,agent 会绕过一串失败调用,最终报告却只说成功,失败的测试 skill 可能藏在通过的测试后面。评分器用 Markdown 写成 rubric,给出不同表现等级的标签和需要调查的阈值;合并 PR 时触发对选定会话的评分。每 24 小时一个 cron agent 拿到前一天样本的失败报告(例如 200 个会话里 50 个失败)和 skills 仓库,找共同原因并提 PR,由团队收件箱审批。个人版是 Skill Doctor(warp.dev/skilldoctor),可分析本地会话。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
软件工厂常见的是「任务 → 评审过的改动」这条路(任务来自看板或 Slack,agent 分诊、写规格、实现);但工厂本身也需要有人来做工程。
- 3:12
收集会话:本地 agent(Claude Code、Codex、pi)把会话文件存在运行它的机器上,个人可以直接让评审者读这些历史;团队需要一个集中存放的地方。
- 5:11
评分 agent 需要三类证据:对话记录(人发了什么、agent 怎么回应、人接着说了什么——反复要求重写 changelog 本身就是证据)、工具调用与结果、最终产出。
- 6:11
现场约 40% 的人举手说 agent 测试写太多,他的团队接近 100%。要给某个 PR 打分,评委必须知道团队认为合适的覆盖度,把「冗余测试」「啰嗦」定义成评委能判断的标准。
- 7:41
效率靠工具 trace 才看得出:短的交互会话里你能看到一串失败调用,但让 agent 在云沙箱里长跑时,你看到的第一样东西可能是最终报告。编码 agent 很会绕障碍,绕过之后就只汇报结果,坏掉的测试 skill 可以藏在通过的测试后面。
- 8:42
Warp 用 Markdown 写评分器(类似 skill 定义),给 LLM 评委不同表现等级的标签(像作文评分标准)和需要调查的阈值,判断 agent 是在推进结果还是在做冗余步骤和无谓往返。
- 10:41
示例:一个已合并的全栈认证服务 PR,合并即触发评分;评估单位是对每个选定会话跑一次评委,按每项标准打分;可以评全部会话或随机抽样。
- 12:41
每 24 小时的 cron agent 查看前一天样本(示例:200 个会话、50 个失败),拿到失败报告和评委说明,以及 skills 仓库,任务是找共同原因并提出修改 skills 和配置的 PR,由团队审批。
- 13:41
个人版 Skill Doctor(warp.dev/skilldoctor)可以分析本地 Claude Code、Codex 或 pi 的会话,分批评分以节省 token,并提出修复建议。
- 16:11
把之后的分数和 skill 修改日期对照,确认修复是否有效。相比让 harness 夜里反思并存储记忆,显式的评分让工程师看得见 agent 得出了什么结论。
可以用在日常工作里的
- 评测
评审 agent 工作时一定看工具 trace,而不只看最终报告;把重复失败、无谓往返当作效率问题打分。
- 团队
把团队对「测试覆盖度」「输出长度」的期望写成 rubric,供 LLM 评委和 agent 共同使用。
- 工程
搭一个每日改进循环:抽样会话 → 评分 → 汇总失败 → 对 skills/配置提 PR → 人审 → 看后续分数。