AI Engineer 2026
Training Your Own Agent Models With RL Is Now Practical
Jason Mancuso · Modal
换模型只能在现有能力组合里挑;用 RL 训练自己的 agent 模型已可行:把失败的生产 trace 变成可重试的任务,用带三项修正的异步 GRPO 让落后的采样器样本仍可用,只传稀疏的权重增量实现跨云采样,混合不同 GPU 生成 rollout,训练依旧稳定且 rollout 成本降 15%。
内容概要
新模型出来,agent 团队跑评测、A/B、围绕最佳性价比模型重建 harness——但只能在已有的能力组合中选择。SFT 只教模型复现录下的那条路径,部署后模型早期一步走偏,后续就进入训练没覆盖的状态;RL 让模型在 harness 里尝试其他路径,用现有评测标准打分,失败的生产 trace 正好提供任务。系统里模型有两份工作:推理 GPU 上的采样器生成 rollout,训练器用梯度下降更新权重;异步时 v1 权重生成的 rollout 可能到达已是 v3 的训练器。Modal 在 GRPO 上加三项修正:掩码重要性采样处理 token 概率差异、处理多次更新间的漂移、考虑 top-p 采样器可选的 token 集合。GPU 碎片化:Modal 汇集约 15–20 家提供商的算力,4 或 8 个节点很快能调度,16 或 32 个连续节点要久得多;agent RL 大约每张训练 GPU 需要两张推理 GPU,把采样器移到别处可以释放训练节点,前提是只传权重增量 Δ = W(t+1) − W(t)(稀疏、可压缩)。不同代 GPU(B200 训练、H100/A100 采样)内核不同会带来数值差异;混合硬件时训练—采样不匹配增加约 4–5 倍,但奖励和梯度范数与全 B200 对照一样稳定,rollout 成本降 15%。实现基于已有的 RL 框架和推理引擎,已发表技术文章并计划开源。
幻灯片截图
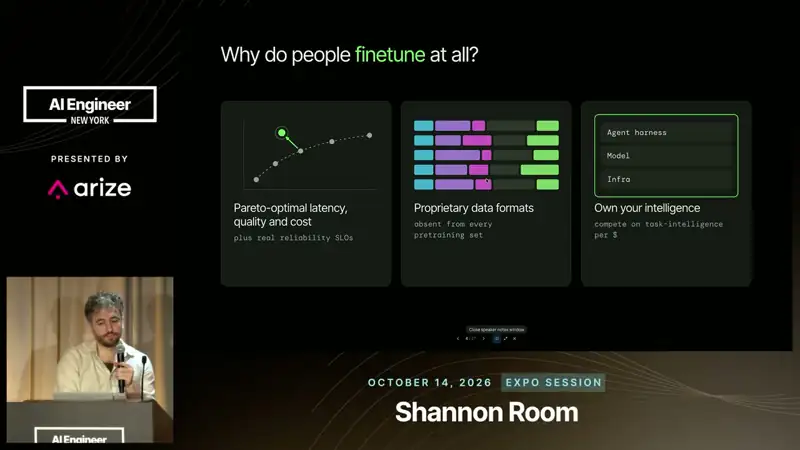
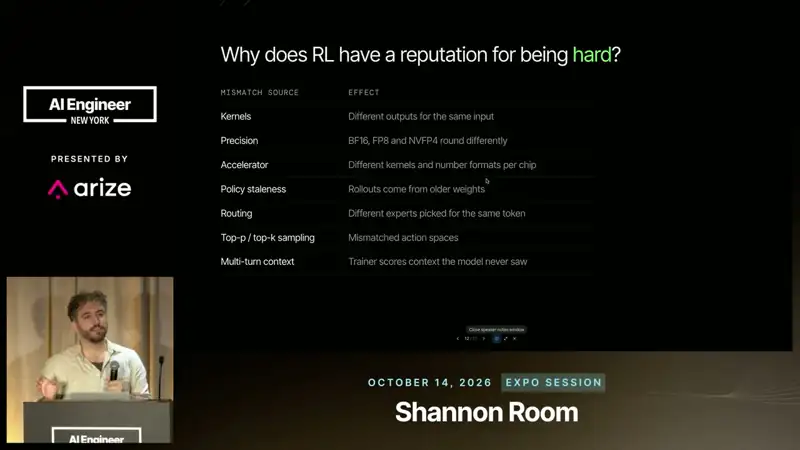
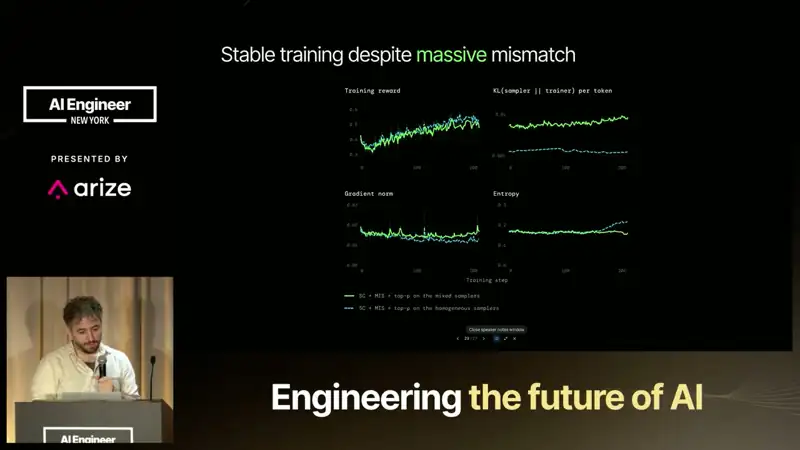
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:01
换模型的策略有上限:团队只能在现有模型的能力组合中选择;训练自己的模型才能把产品特有的行为放进权重。
- 3:35
SFT 只教录下的那条路径,模型部署后早期一步不同就进入未覆盖的状态;RL 让模型在 harness 中尝试其他路径,失败的生产 trace 提供任务,现有评测标准打分。
- 6:51
采样器(推理 GPU 上生成 rollout)与训练器(更新权重)分离;异步运行时,v1 权重生成的 rollout 可能到达已是 v3 的训练器。
- 9:38
异步 GRPO 的三项修正:掩码重要性采样处理 token 概率差异、修正跨更新的漂移、考虑 top-p 采样器可选的 token 集合。
- 12:34
Modal 汇集约 15–20 家云的 GPU;4/8 节点好调度,16/32 个连续节点难。agent RL 约 2 张推理 GPU 配 1 张训练 GPU,把采样器分散到别的云,只传稀疏的权重增量。
- 17:33
B200 训练 + H100/A100 等混合采样:训练—采样不匹配增加约 4–5 倍,但奖励与梯度范数和全 B200 对照一样稳定,rollout 成本降 15%。
- 19:18
「拥有 agent 技术栈」意味着理解现有 RL 框架与推理引擎这些组件;Modal 已发布技术文章并计划开源代码。
可以用在日常工作里的
- 模型
如果你有大量带评分的 agent 任务(评测 + 失败 trace),RL 微调开源模型已经是可行选项,而不仅是前沿实验室的事。
- 基础设施
RL 的大头成本在 rollout 生成;可利用更便宜、分散的 GPU 采样。