AI Engineer 2026
Your Company Should Train Its Own AI Models
Will Brown · Prime Intellect(应用研究负责人)
agent 今天被纠正、明天又犯同样的错:把纠正和触发它的情境一起保存,变成测试用例和训练样本;公司可以只训练 agent 系统里窄的一部分(路由器、审批/决策模型),用夜间空闲的推理算力训练——约 30 万美元的一次训练,和招一名工程师是同一量级的决策。
内容概要
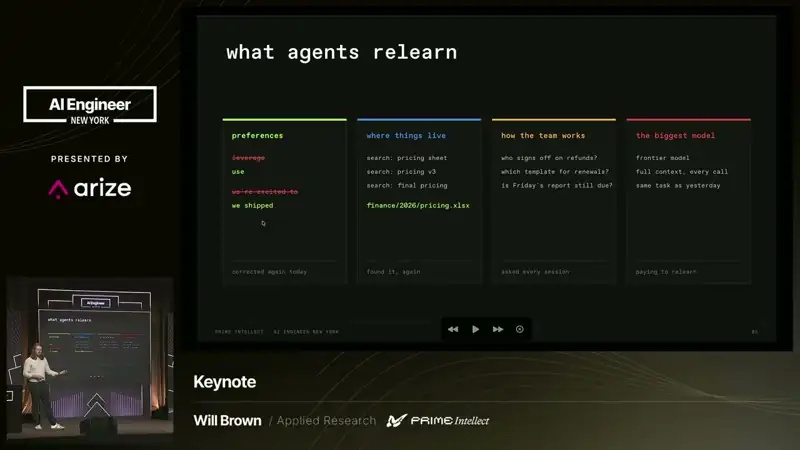
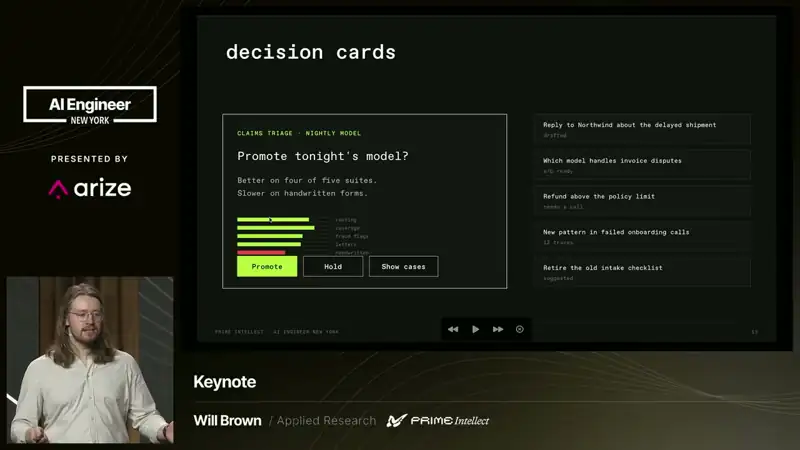
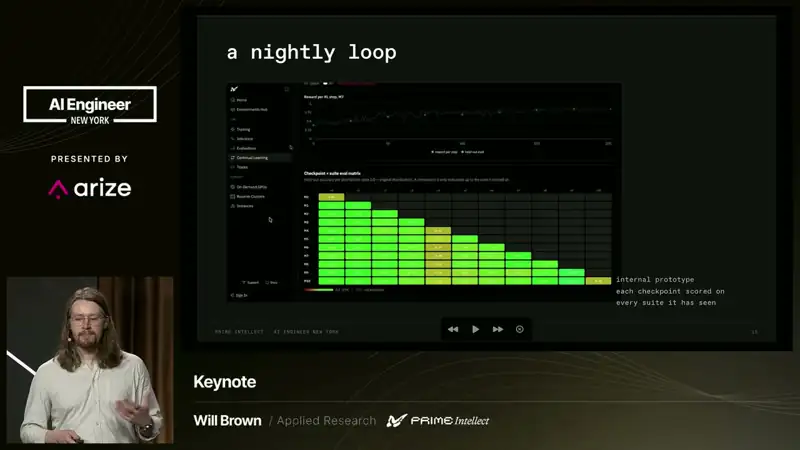
组织架构图不显示「谁的支持能让改动被采纳」,老员工却知道——这类判断正是 agent 缺的。给 agent 一个 skill 文件和仓库,它在会话里能弄明白很多,但下次重来还要重新读、重新探索;缓存能降成本,却不会让知识进入权重。前沿模型学会某个 Salesforce 工具组合,要经过专家网络、标注者、构建者、实验室的长链条;公司内部员工每天已经在做这些判断。做法:像对待代码库一样对待模型,真实使用暴露出值得检查的行为时就加一个测试用例;trace 记录提示、agent 的动作和用户反馈,提示成为将来的测试输入,用户偏好的替代方案成为期望行为。多 bot 的界面问题:20 个 bot 同时跑,找出需要回答的线程本身就是工作;他实验让 agent 在需要人决策时即时生成一张任务专属卡片,人的回答直接成为这道题的标签,给决策模型一个明确目标,减少可被钻空子的代理奖励。可以只训练路由(同一任务上的对比教会它何时便宜模型够用)或审批模型,前沿模型继续做主体工作。一家用 Prime Intellect 工具的公司花约 30 万美元训练了处理表格和幻灯片等知识工作的模型,他称接近该类工作的帕累托前沿(未给具体分数)。内部原型:收集 agent trace,人查看被标记的问题和建议的实验,决定今晚是否开训;白天推理容量服务员工,夜里需求下降时拿来训练。顺序:先发现工作流 → 为能说清的步骤写 skills → 建评测 → 再决定哪些值得进权重。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
组织架构图里没有「谁的支持能让改动被采纳」「哪些指令会被执行」——资深员工的这类判断恰恰是 agent 缺少的。
- 5:41
什么值得进权重?skill 文件 + 仓库能让 agent 在会话里搞懂很多,但每次重来都要重读、重探索;缓存降低重复输入的成本,却不会让 agent 记住纠正。
- 10:59
像对待代码库一样对待模型:真实使用暴露值得检查的行为时就加测试用例;trace 包含提示、agent 动作和用户反馈——提示是未来的测试输入,用户偏好的方案是期望行为。
- 14:58
20 个 bot 并行时,找出需要你回答的线程本身就是工作。让 agent 在需要人决策时即时生成任务专属卡片:人的回答同时成为这道题的标签,给决策模型一个明确目标。
- 16:00
可以只训练系统中窄的一部分:同一任务的对比教路由器何时便宜模型够用;员工的选择教审批模型批什么;前沿模型继续做主体工作。
- 17:08
一家公司用 Prime Intellect 工具花约 30 万美元训练表格、幻灯片类知识工作模型,他称接近帕累托前沿;这与招聘一名工程师是同一量级的决策,也可随样本积累分摊。
- 18:10
夜间训练:白天推理容量服务员工,夜里需求下降时用于训练;原型中人查看 trace 里被标记的问题和建议的实验,再决定是否开训。权重的改变会让没见过原始错误的员工也受益。
可以用在日常工作里的
- 模型
从现在开始保存「纠正 + 情境」:agent 做了什么、人希望它怎么做。先变成评测,积累够了再考虑微调或 RL。
- 产品
多 agent 时,用结构化的「决策卡片」请求人类输入,比翻聊天线程高效,且天然产生标注数据。