AI Engineer Europe 2026
From 46% to 90%: Fine-Tuning Tiny LLMs for On-Device Agents
Cormac Brick · Google AI Edge
端侧 agent 的两条路:用系统内置模型(Android AI Core 上的 Gemini Nano / Gemma 4)加按需加载的 skills;或在应用里自带专用小模型(LiteRT-LM 运行),用合成数据微调 2.7 亿参数的 FunctionGemma,把应用函数调用成功率从约 46% 提到 8/10 个函数超过 90%。
内容概要
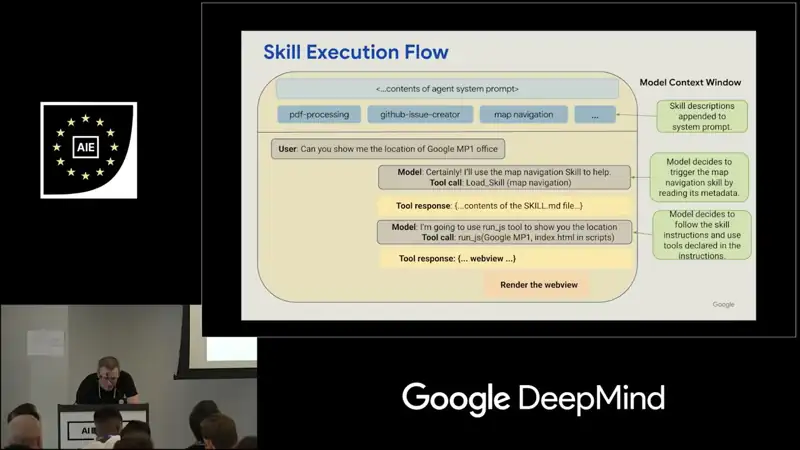
设备上内置的智能不覆盖你的用例时怎么办?Google AI Edge 的栈把应用集成与模型执行分开:LiteRT-LM 是给自带或下载模型的应用用的 LLM harness。路径一「系统生成式 AI」:Android 上通过 AI Core 用 Gemini Nano(例如摘要 API),iOS 上有 Apple Intelligence;Gemma 4 E2B/E4B 是系统模型候选。Google AI Edge Gallery 是在 Android/iOS 本地跑模型的试验场,示例是餐厅挑选器。skills 的 harness:系统提示 + skill 描述目录,需要时用 load-skill 工具加载完整说明,避免把所有函数塞进初始提示;团队用 Gemini CLI 和 Claude Code 写了约 80 个 skill。路径二:应用自带模型,LiteRT-LM 运行包含所有执行信息的单个模型文件,开源、跨平台。FunctionGemma 是基于 Gemma 3 的 2.7 亿参数模型,开箱对他们的 7 个函数成功率约 46%,用合成数据微调后 10 个函数中 8 个超过 90%、2 个在 80% 多。第二个例子 Eloquent 转录应用,把专用模型串起来做离线、带个性化词汇(术语、人名)的转录。问答:4B 模型选一个 skill 容易,协调多个 skill 更难。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:37
Google AI Edge 的栈:LiteRT-LM 是自带或下载模型的应用用的 LLM harness;应用集成与模型执行分开。
- 2:58
路径一「系统生成式 AI」:Android 通过 AI Core 用 Gemini Nano(如摘要 API),iOS 上 Apple Intelligence 类似;Gemma 4 E2B/E4B 可作为系统模型。
- 7:43
按需加载 skill:系统提示 + skill 描述目录,模型需要时调用 load-skill 工具取回完整说明和函数,避免塞满初始提示——小模型同样适用渐进披露。
- 8:59
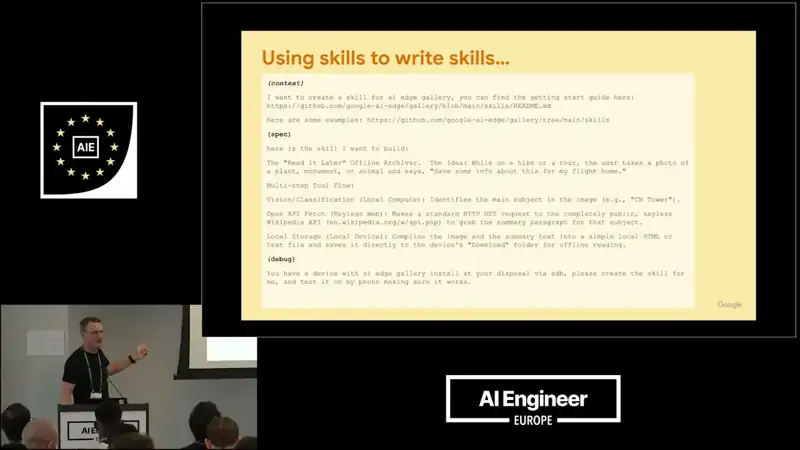
团队用 Gemini CLI 和 Claude Code 编写了约 80 个 skill,有 Gallery 的 skill 编写指南。
- 10:18
路径二:应用自带模型,LiteRT-LM 运行包含执行所需全部信息的单一模型文件,开源、跨平台(C++/Java 接口已可用)。
- 13:13
FunctionGemma(2.7 亿参数,基于 Gemma 3):开箱对应用函数调用成功率约 46%;用合成数据针对 7–10 个函数微调后,8 个函数超过 90%,2 个在 80% 多。
- 15:52
Eloquent:把专用小模型串联做离线转录,并个性化术语、人名和偏好关键词。
- 17:41
4B 模型选择单个 skill 相对容易,协调多个 skill 更难。
可以用在日常工作里的
- 模型
端侧或低成本场景:先列出应用的函数,用强模型生成合成调用数据,微调一个数亿参数的函数调用模型。
- agent
即使是小模型也用 skill 目录 + 按需加载,而不是把所有工具一次性给出。