AI Engineer CODE Summit 2026
Your SKILL.md Is 70% Stuff the Model Already Knows
Nikolay Petrov · Intel
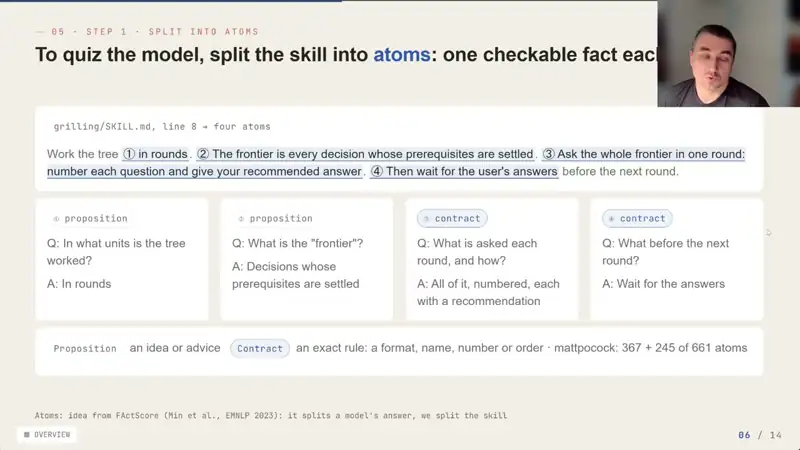
借鉴 FActScore:把知识型 skill 拆成 25–30 条可检验的断言,每条配一个问题和期望答案,分别在「不加载 / 加载 skill」时提问;四种结果(会→会、会→不会、不会→会、不会→不会)标回原文每一行,再用删除实验在原任务上验证。
内容概要
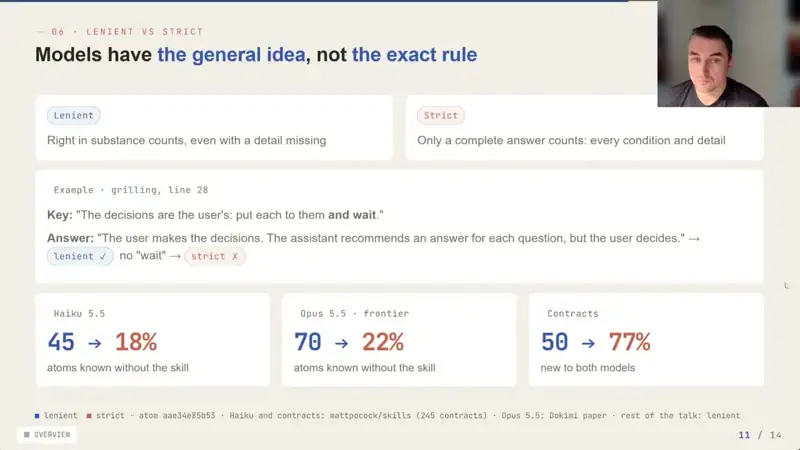
Petrov 区分两类 skill:流程型(让 agent 以可重复的顺序做熟悉的事)和知识型(提供解决问题所需的信息)。对知识型 skill,值得问模型本来就懂多少。做法:从可检验结果的任务开始;把 skill 拆成可单独检查的条目,可以是关于事物如何运作的命题,也可以是规定 agent 应采取什么行动的「契约」;每条写一个问题和期望答案,目标模型在两种条件下回答同一问题(答案不出现在问题里,基线才有信息量)。四种结果:会→会(可缩短)、会→不会(加载 skill 反而弄坏了,罕见:某合集约 400 条里只有 1 条)、不会→会(skill 真正教会了东西)、不会→不会。把结果按行着色标回原文。评分精度很关键:宽松(懂大意)时较大模型已知 70%,严格(要具体键、参数、值、步骤)时降到 22%。同一文件对不同模型价值不同,小模型通常知道得更少。最后用删除实验:删掉模型已知内容,重跑原任务看是否仍能解决。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:00
反复手打的提示适合做成 skill。流程型 skill 让 agent 按可重复顺序做熟悉的事;知识型 skill 提供解题所需的信息,对后者值得测模型本来就知道多少。先从结果可检验的任务开始。
- 4:00
借鉴 FActScore:把 skill 拆成小到能单独检查的条目——关于事物如何运作的命题,或规定 agent 该做什么的「契约」。每条写问题和期望答案,一个 skill 大约 25–30 条;目标模型在两次运行中看到同一个问题,只有一次加载了 skill。
- 5:55
四种结果:会→会(模型本来就能答,对应段落可缩短);会→不会(加载 skill 反而弄坏了正确答案,检查相关指令);不会→会(skill 真正教了东西);不会→不会。先看基线,再看加载后的结果。
- 7:28
回归很少见:在一个流行合集中约 400 条只有 1 条出现「会→不会」,但即使一条也给了编辑一个具体要查的段落。把每条结果按颜色标回源文件的行,编辑一眼看到哪些段落有用。
- 9:16
评分精度:宽松评分接受大意,严格评分检查任务需要的具体键、参数、值或步骤顺序。较大模型在宽松标准下已知 70% 的内容,严格要求具体细节时降到 22%——能解释参数作用不等于给出能用的值。
- 10:30
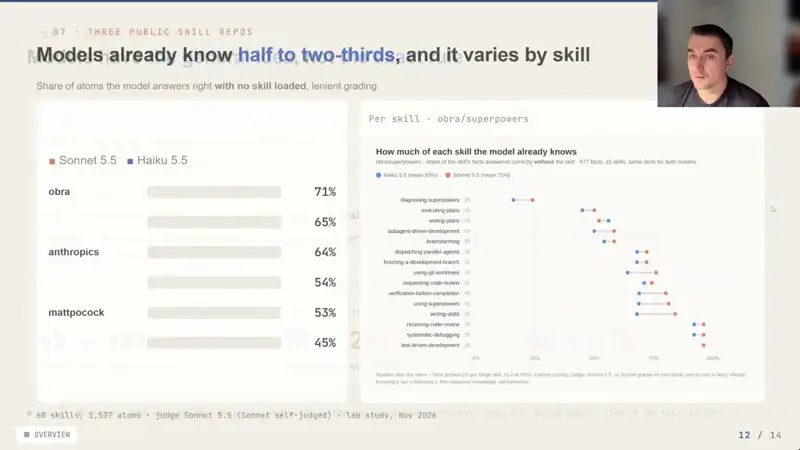
同一文件对不同模型价值不同:在三个流行 skill 仓库上,小模型普遍比 Sonnet 知道得少;在 Sonnet 上看似冗余的段落对小模型可能仍有用。不同 skill 结果差异很大。
- 11:55
删除实验:模型能直接解释某个概念,不代表做任务时不需要提醒。删掉模型已能解释的部分,加载缩短后的 skill 重跑原任务评测;若仍能解决同样问题,就省下输入 token、腾出上下文。
可以用在日常工作里的
- 上下文
给知识型 skill 做「断言级」测试:同一问题在有/无 skill 下各问一次,按实际需要的精度评分。
- 上下文
删内容之前一定在原任务上重跑评测;针对你实际使用的模型(大小不同)分别验证。