AI Engineer World's Fair 2026
Don't Ship Skills Without Evals
Philipp Schmid · Google DeepMind
skill 只有在让 agent 行为变好时才有用:精准的触发描述、固定流程写成脚本、需要判断处只给目标与约束;在干净工作区里每个用例跑 3–6 次,用正则/trace 验证器 + LLM 评委打分,并且一定要做「有无 skill」对比。
内容概要
现场几乎人人用编码 agent 和 skills,但几乎没人给 skill 写评测。SkillsBench 索引了 5 万多个 GitHub 上的 skills。skill 是一个含 SKILL.md 和资源的文件夹,靠渐进式披露分三层进入上下文:名称描述(用于选择)、正文(读取时)、参考资料(需要细节时)。用户调用适合熟悉的开发流程(开 PR、发文档),能避免常驻上下文;面向客户的场景依赖模型触发,描述必须精准。固定顺序的流程写成脚本让 agent 调用,需要判断的地方描述目标和约束。案例:为模型训练之后才发布的 Gemini Interactions API 写 skill,补足 API 知识并引导使用最新模型;很多要求能用正则检查(正确 SDK、模型 ID、方法、禁止旧写法)。Google DeepMind 内部把评测放在每个 skill 旁边:多个提示用例、干净工作区、启动命令、trace 验证器(是否读了 skill、执行了哪些命令)和 LLM 评委。他观察到的失败有 50% 是用户提示信息不足导致 skill 没被正确触发;触发只是诊断指标,最终看结果。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:16
现场:用编码 agent 和 skills 的人很多,给 skills 写评测的人几乎没有。接受一个看起来合理的 SKILL.md 很容易,证明它有用很难。SkillsBench 索引了 5 万多个 GitHub 上的 skills。
- 2:27
skill = 文件夹(SKILL.md + 资源),核心机制是渐进式披露:发现层(名称和描述)、指令层(SKILL.md 正文,读取时进入)、支持材料(参考资料,任务需要细节时才加载)。skill 也有生命周期,模型学会后就该退休。
- 5:34
先决定调用方式:模型触发依赖模型把请求和描述匹配上;用户显式调用适合开 PR、部署文档等熟悉流程,能避免常驻上下文。描述要写清触发指令。
- 9:03
给 agent 合适的自由度:总是同样步骤同样顺序的流程写成脚本让 agent 调用,不必让模型花 token 重建不变的流程;需要判断的地方描述目标和约束(比如改数据库配置:指明配置文件和要做的修改,而不是逐步指令)。
- 12:35
案例:Gemini Interactions API 发布于 Gemini 3/3.1/3.5 的训练之后,模型缺乏可靠使用它的知识;skill 的任务是补上 API 知识并引导代码使用最新模型。
- 14:32
很多要求可以机械检查:正确的 SDK、正确的模型 ID、正确的方法、没有过时写法。用正则断言(required/forbidden)便宜且可频繁运行,新模型发布时只需更新期望的标识符,不需要为字符串级要求引入 LLM 评委。
- 15:45
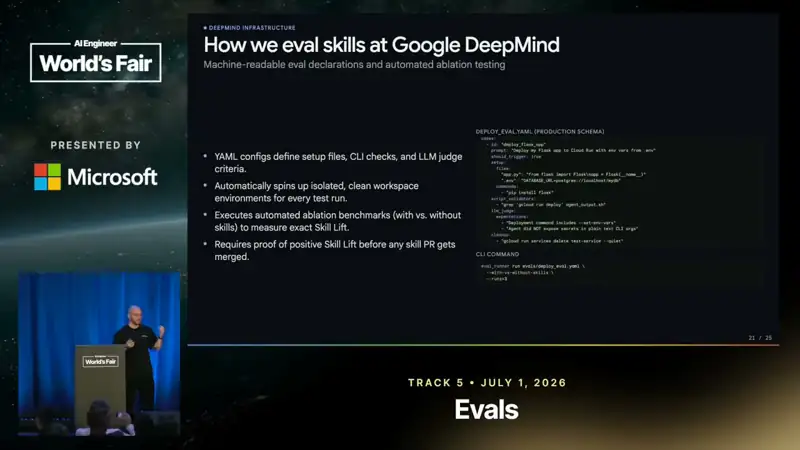
DeepMind 内部把评测放在每个 skill 旁边:多个提示用例、可包含应用文件的干净工作区、预装依赖的启动命令、检查 trace 的脚本验证器(是否读了 skill、执行了哪些命令和 CLI)、以及评估更宽泛期望的 LLM 评委;每次改 skill 都重跑。
- 17:22
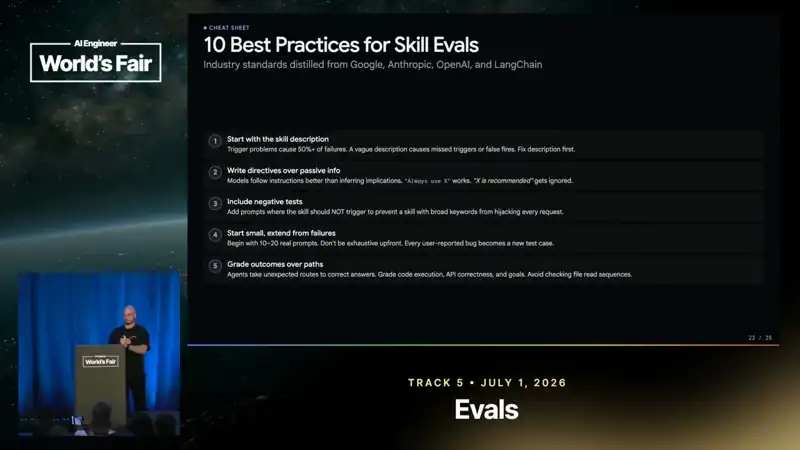
他观察到的失败中 50% 是用户提示缺少细节导致 skill 触发错误;客户不知道 agent 上下文里的描述,所以简短、含糊的请求必须进评测集,并加反例测试。但触发只是诊断,最终要衡量结果而不是规定路径。
- 18:46
隔离:在已有开发环境里 agent 可能从之前的对话或产物里「偷看」答案,所以用干净工作区;每个用例重复 3–6 次;覆盖用户真实使用的 harness(Claude Code、Antigravity、Cursor 表现可能不同)。
- 20:18
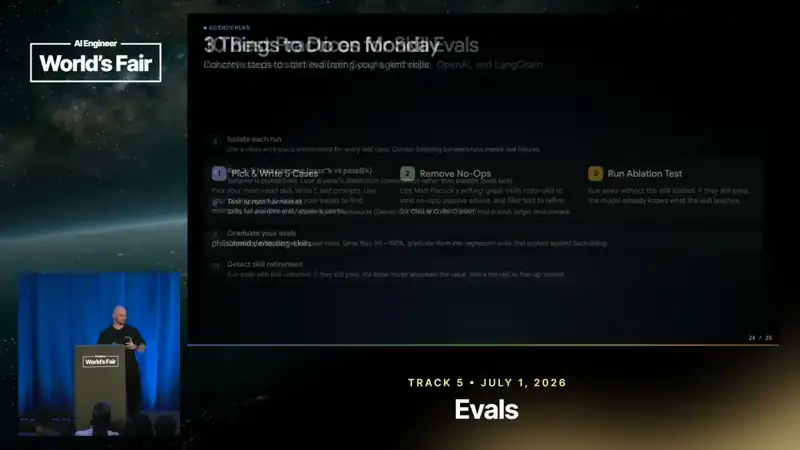
假期回来就能做的练习:挑最常用的 skill(不确定就让 agent 分析轨迹)、写 5 个测试提示、用 JSON/YAML + Python 脚本跑并检查结果、删掉无效指令(分数不变也省 token)、跑有/无 skill 对比确定它的价值。
可以用在日常工作里的
- 上下文
为最常用的 3 个 skill 各写 5 个测试提示,包含含糊请求和反例,在干净目录里各跑 3 次。
- 评测
能用正则/文件检查判断的要求不要用 LLM 评委;LLM 评委只留给需要解读的部分。
- 上下文
固定步骤写成脚本让 skill 调用,skill 正文只写目标、约束和坑点。