AI Engineer
AI Writes the Code. So What's Left for Engineers?(The Rise of the Product Engineer)
Laurie Voss · Arize AI(npm 联合创始人)
代码变得几乎免费,瓶颈按「约束理论」一路后移:评审 → 运维 → 安全;最后留给人的是弄清用户要什么、定义什么是「好」——产品工程师。要有意识地培养它,并把最好的人的判断写进规格、rubric 和评测。
内容概要
Laurie 用一页页带出处的数据论证:开 agent 的开发者多写 741% 的代码,发布只快 30%,卡在评审;人每小时只能可靠审约 450 行。机器评审在接手(Copilot 做了 GitHub 五分之一以上的评审),但四个 AI 评审器在同样 146 个 PR 上没有一个 bug 是四家都发现的;完全不读代码也翻车了(Dex Horthy 公开认错,Amazon 要求资深签字)。测试通过 80% 的 PR,换成「维护者愿意合并吗」只剩 54%,差的就是「什么是好」。按 Goldratt 的约束理论,修好一个瓶颈它就转移;agent 最难吃掉的是「决定做什么、定义好、让人喜欢」,这些知识不在训练数据里、也没有规模经济。产品工程师 = 了解需求、定义好、用 agent 交付;初级工程师的学徒路径(写代码被评审)已被自动化,需要有意培养。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:21
代码几乎免费后,瓶颈从写代码移到后面的环节;当下是评审,之后还会继续移动,直到遇到 agent 过不去的那一个——那就是留给人的工作。
- 3:04
数据:NBER 10 万+ GitHub 开发者,agent 带来 +741% 代码、+30% 发布;LinearB:agent PR 等评审时间长 4.6 倍;Faros 2.2 万开发者:评审时间 +440%、每 PR 事故 +240%;Cisco/SmartBear:人每小时审约 450 行后准确率崩溃。
- 4:24
「产生看似合理的代码的成本崩塌了,判断能否信任它的成本没有变。」
- 4:36
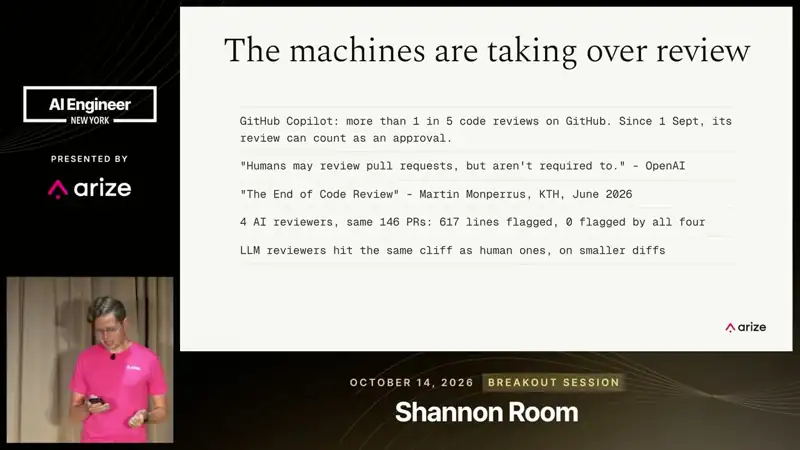
机器正在接管评审:Copilot 做了 GitHub 五分之一以上的评审,且可作为批准;但 KTH 研究中四个 AI 评审器在 146 个 PR 上共标记 617 行,没有一处被四家同时标记——值得跑,但要跑多个。
- 5:48
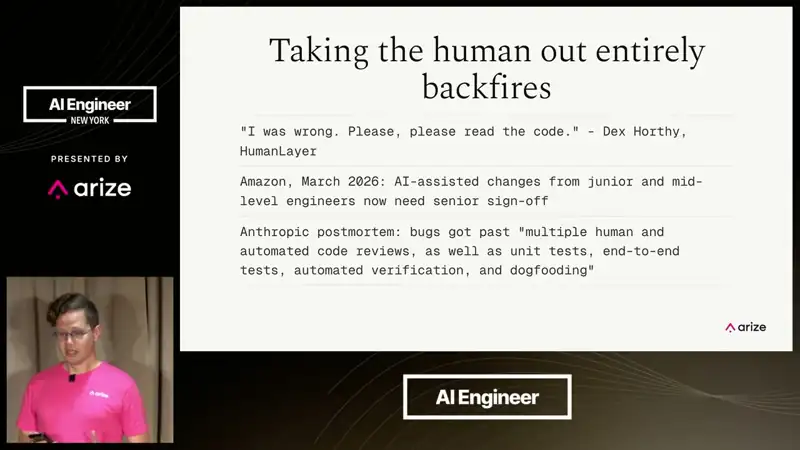
完全拿掉人会反噬:Dex Horthy 说「我错了,请读代码」;Amazon 2026 年 3 月起要求初中级工程师的 AI 改动经资深签字;Anthropic 事后复盘有 bug 穿过了多层人工和自动评审、单测、端到端测试和自测。
- 6:44
Agent 能通过某编码基准 80% 的测试,但若由维护者判断「是否会合并」只有 54%:差距在代码风格、副作用、外部系统、未写进代码的历史,也就是「好」的定义。
- 8:00
约束理论:只有加速瓶颈才有用;修好瓶颈,它会移到下一处。评审之后大概率是运维和扩容,再之后是安全,他预计需要 5–10 年。前提是软件需求近乎无限。
- 11:20
被 agent 吃掉的顺序:已崩塌——写代码;很快——评审与维护;下一个——上线与扩容;可能安全——决定做什么、定义「好」、让它令人愉悦。
- 11:52
「只有面包师知道面包店需要什么」:订单管理软件有一万种,适合面包店的只有一种;这种知识不在权重里,只能和人谈出来,而且不能迁移,没有规模经济(看看 Jira)。
- 14:52
谁定义「好」,谁就在训练明年的模型:Cognition 定义了「可合并」并训练 SWE-2;Cursor Bugbot 把团队的点踩变成规则,已在 11 万仓库学到 4.4 万条。知识一旦写下来,瓶颈就再次移动。
- 16:56
产品工程师:找出人们需要什么、定义好、用 agent 交付。FDE 职位 2025 年 9 个月增长 800%,约 1,000 个在招,平均总包约 24 万美元,资深岗超 60 万。
- 19:44
22–25 岁软件开发者就业自 ChatGPT 后下降约 19%,41–49 岁上升。代码评审曾是学徒制,现在被自动化了;需要有意培养:第一天就让新人面对客户,让他们写规格和评测、agent 写代码,评审他们的规格和对话记录而不只是 diff。
- 25:08
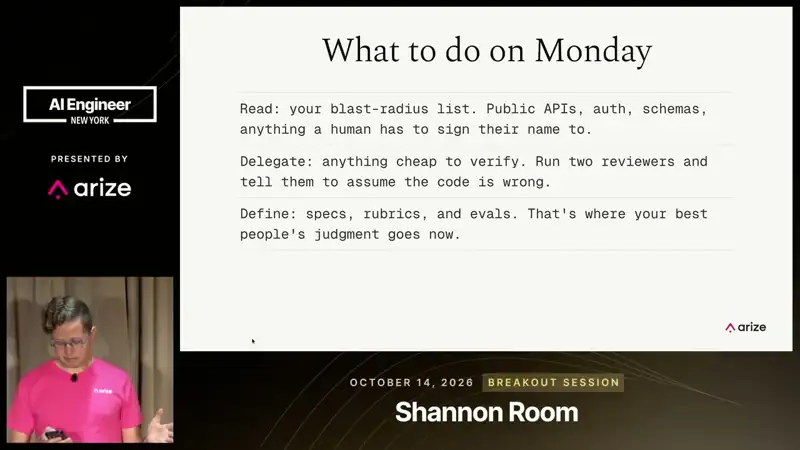
周一就能做的:只人工审「爆炸半径清单」(公开 API、鉴权、schema、需要人签字的东西);验证成本低的全部委托,跑两个评审器并让它们假设代码是错的;把最好的人的判断投入规格、rubric 和评测。衡量交付了什么,而不是写了多少;最后的评审者是生产环境。
可以用在日常工作里的
- 团队
写一份「爆炸半径清单」(公开 API、鉴权、数据库 schema、计费等),人工评审只集中在这里,其余交给多重自动评审。
- 质量
并行跑两个以上 AI 评审器,提示它们「假设代码有错」;同时度量「测试通过」与「维护者会合并」之间的差距。
- 产品
把领域知识外化:与用户访谈后写成规格、rubric 和评测,这些是 agent 时代最值钱的资产。
- 团队
重新设计初级岗位:面向客户、写规格和评测,评审他们的规格和 agent 对话,而不只是代码。
- 工程
指标从代码行数、PR 数改为:实际上线量、评审意见被采纳率、生产表现(用模型给线上行为打分)。