AI Engineer Paris 2026
Fixing the PR Bottleneck
Matt Pocock · AI Hero
在 PR 到达人之前把它变好:识破「绿色 CI 证明了错的东西」,用深模块让 agent 写出有意义的测试,把编码规范放进独立的评审子 agent 直接提交修复,PR 描述写清「单向门/双向门」与爆炸半径,再用 retro 让同一条评审意见永远不写第二遍。
内容概要
Matt 认为软件工厂需要刹车:自动发起的工作 + agent 的产能会变成「slop 大炮」,而且代码就是下一个 agent 的工作环境,烂代码会自我复制。他举了三种「看起来让人放心却没测到行为」的测试:重复断言常量(实现写 280,测试断言等于 280)、按源码顺序而非 UI 顺序检查、过于简单的 mock。对策是 Ousterhout 的深模块:小接口背后藏大量行为,让测试通过接口而不是内部细节;他的 module-deepening skill 会找出可深化的模块。编码规范不放进实现 agent 的上下文(它已经要找代码、改代码、调试),而是交给一个读 diff + 仓库规范文件的独立评审子 agent,先「让它跑起来」再「让它变好」,评审结果直接以提交修复而不是长串评论交付。PR 描述按单向门/双向门和爆炸半径分配人工注意力(一个给 6 万人发邮件的小改动无法撤回);Retro skill 读会话和 PR,提出新的检查与规范。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:01
软件工厂需要刹车:分类器把来件变成修复或复现任务,PlanetScale 的慢查询报告也能触发工作流;永久加速会变成「slop 大炮」。更深一层的代价是:代码就是下一个 agent 的工作环境。
- 4:50
绿色 CI 只证明检查通过了,不证明可以合并。三个反例:断言常量等于 280(实现和测试含同一个答案,还耦合了内部命名);按源码顺序而非 UI 显示顺序检查;mock 过于简单。自动和人工评审都是「测谎仪」,要追问检查到底证明了什么。
- 8:22
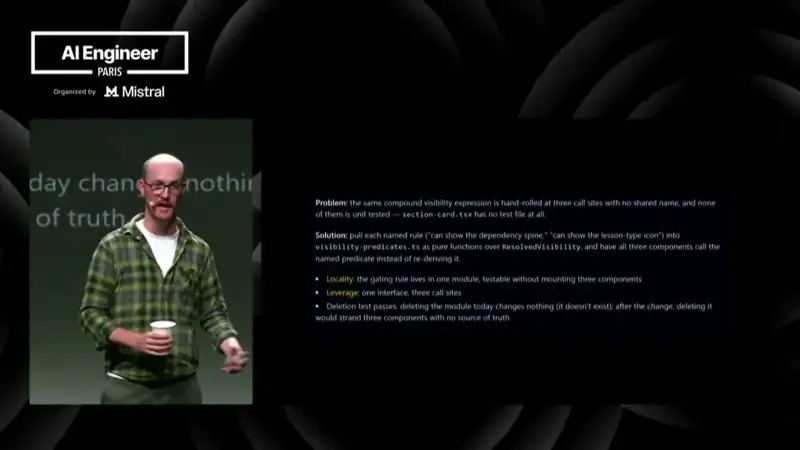
用深模块(小接口、大实现)引导 agent 写有意义的测试:浅模块暴露很多小函数,测试就会依赖内部细节。他的 module-deepening skill 提出可深化的建议,而不是自动改;还要明确要求 agent 通过接口去测。
- 11:30
反直觉:别把详细编码规范塞进实现 agent 的上下文,它已经要找代码、改代码、跑检查调试。评审 skill 在独立子 agent 里读 diff 和仓库规范文件,专注评估规范——先「让它跑起来」,再「让它变好」,类似红-绿-重构分在不同上下文。
- 14:22
通用的自动评审要么规则太宽误报多,要么太窄只适用某种语言;更好的是团队逐步建设自己的评审标准,把躺在文档里没人看的规则变成每次改动都执行的标准。评审的默认输出应是直接提交修复,而不是一串需要人逐条判断的评论。
- 16:23
PR skill:按单向门/双向门分配注意力。双向门可轻易回滚;单向门(给 6 万人发邮件、昂贵迁移、数据丢失)回滚代码也无法撤销。PR 底部写「合并危险度」:门的类型 + 失败的爆炸半径;diff 大小不是风险的好代理。他还推荐用伪代码和图示(如 HumanLayer 的 show-me skill)帮人快速理解改动。
- 19:44
目标:同一条评审意见永远不写第二遍。Retro skill 的输入可以是一次会话、一个 PR 加会话或一周的 PR 和评审,它会提出新的自动检查、更新 codingstandards.md,并找出导航、工具选择上的浪费。会话比 diff 多了「agent 是怎么得出结果的」。
可以用在日常工作里的
- 质量
让评审 agent 专门检查「测试证明了什么」:重复常量、源码顺序断言、过度 mock 都要标出来。
- 工程
把模块设计成深模块并要求 agent 通过公开接口测试;定期让 agent 提出可深化模块的建议。
- 编码 Agent
实现与规范检查分两个上下文:实现 agent 只管做出来,独立评审子 agent 读规范文件并直接提交修复。
- 团队
PR 模板加一段「合并危险度」:单向门还是双向门、爆炸半径多大,按此决定需要几个人审。
- 团队
每周跑一次 retro:从 agent 会话和评审意见中提炼新的 lint/检查和规范条目。