AI Engineer World's Fair 2026
Building Closed-Loop Evals for a Multimodal Agent at Scale
Soumya Gupta、Jai Chopra · Uber
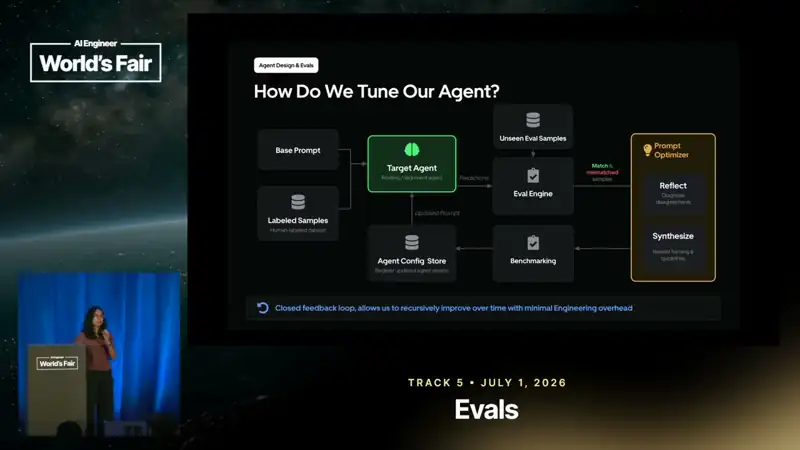
Uber Eats 改进商家菜品图的多模态 agent:理解与路由(增强还是跳过)→ 针对单张图生成编辑提示 → 多维 QA 闭环(失败带反馈重试、有上限)→ 独立的发布前 QA;路由用人工标注当混淆矩阵评测,生成用「原图 vs 新图」成对比较;生产抽样标注不一致时由诊断 agent 定位并自动调优,过金标集才能上线。
内容概要
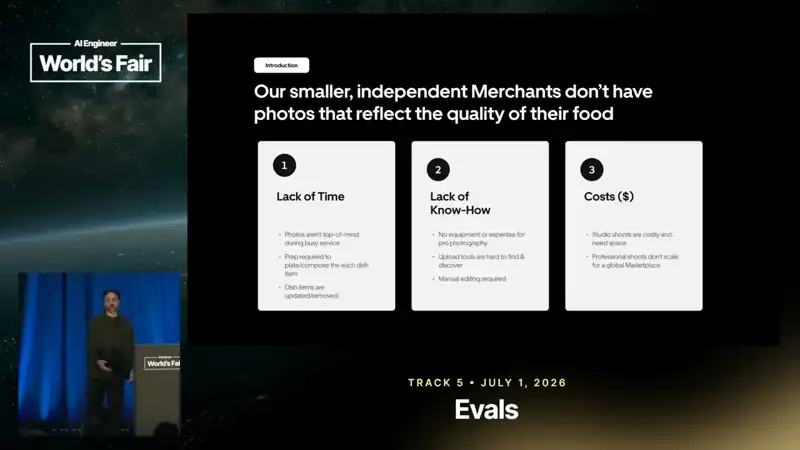
Uber Eats 每月新增数百万菜品,图片质量参差。难点是「让照片更好看却不改变食物」:编辑必须忠于原菜、保留商家品牌,还不能让所有餐厅看起来一样——单一编辑提示会让市场多样性坍缩。执行路径:多模态 LLM 描述照片并输出结构化结果,路由器决定增强还是跳过(跳过保留原图);增强时由编辑 agent 改图、QA agent 反馈、可循环修改,多次失败就不发布;通过的候选再经后处理和发布前 QA。路由评测:把描述按 rubric 打分得出决定,与人工判断对比(混淆矩阵、精确率/召回率);误把好照片送去增强既浪费算力又可能降质(芝士汉堡例子),图里 6 只鸡翅而描述写 8 块则是忠实度问题。生产中定期抽样交给人按同一标准标注,不一致交给诊断 agent 定位并触发自动调优,必须通过金标指标才能发布。生成评测用成对比较,「更好」的定义与产品、设计、政策、法务对齐(忠实、完整、自然、真实),结果可以是是/否/不确定;还要抓「过度纠正」(被拒后退回成通用陶瓷碗,算奖励作弊)和不合理物体。多层检查依「瑞士奶酪模型」叠加。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:52
背景:约 900 亿美元年化市场规模、1 万座城市、每月新增数百万菜品。问题:怎样在保持代表性的前提下改进数百万张菜品照片。
- 2:32
消费者不信任 AI 生成图:编辑必须忠于原菜、保留商家品牌,并避免所有餐厅看起来一样——单一编辑提示会让市场多样性坍缩。输入图片的光线、角度、质量差异极大,不能一刀切。
- 5:21
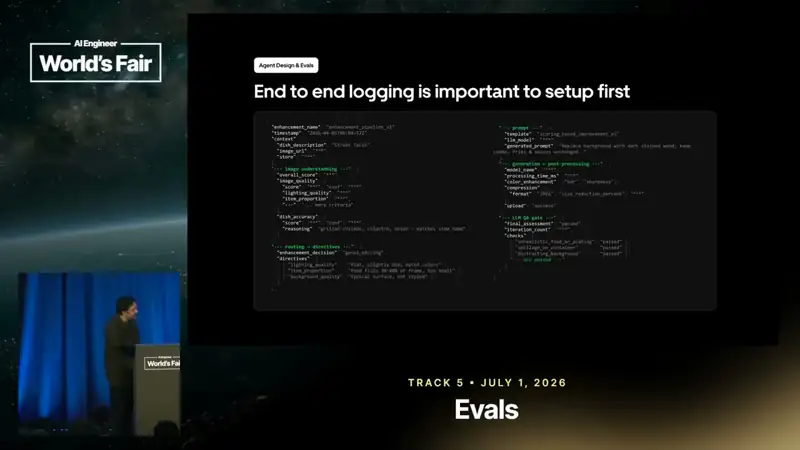
执行路径:多模态 LLM 理解图片并输出结构化描述 → 路由器选择增强或跳过(跳过保留原图)→ 编辑 agent 改图、QA agent 给反馈并可循环修改 → 多次仍失败则不发布 → 成功候选进入后处理和发布前检查;整个执行过程全程记录。
- 7:11
路由评测:图片 + 文字描述 + 元数据,模型按 rubric 的通过/不通过标准评分得出增强或跳过;与人工判断比较,用混淆矩阵、精确率和召回率衡量不同方面的错误。
- 9:44
路由错误会变成忠实度错误:把高质量的芝士汉堡照片误送去增强,花了算力没提升还可能降质;照片里 6 只鸡翅而描述写 8 块,编辑时不能「补」出两只。
- 10:51
生产闭环:定期抽样生产数据交给人工按离线基准同一标准标注;agent 与标注不一致时交给总领的「诊断 agent」定位问题并触发自动调优;调优后的 agent 必须通过金标数据集指标才能发布,否则继续循环。
- 13:20
增强时为每张图单独生成编辑提示(结合描述和路由给出的改进方向),之后经过多维 QA 关卡(摆盘、忠实度、颜色等);失败时把 QA 反馈连同原始输入一起送回提示生成。
- 14:47
生成评测用成对比较:把原图和输出放在一起判断是否更好。「更好」的定义与产品、设计、政策、法务对齐,公开的维度包括忠实、完整、自然、真实,结果可以是是/否/不确定。
- 16:15
警惕反馈把编辑推向无用方向:第一次有创意的编辑被拒后,下一次过度纠正成一个通用陶瓷碗,这是奖励作弊——像素变化很大却没有实质改进;只奖励「变化」的评估器会漏掉这种情况。
- 17:39
通过编辑 QA 不等于发布:候选还要经过后处理和发布前 QA(政策和质量检查)。按「瑞士奶酪模型」叠加多层检查,有些检查故意重复。
可以用在日常工作里的
- 评测
把 agent 拆成可单独评测的决策点(如路由),用人工标注做混淆矩阵,而不是只看端到端效果。
- 评测
生成类任务用「输入 vs 输出」成对比较,并把「更好」的定义与产品、法务等对齐;允许「不确定」。
- 工程
建立生产抽样标注 → 不一致诊断 → 自动调优 → 金标门禁的闭环,并设重试上限与独立的发布前检查。