Dwarkesh Podcast(黑板讲座,节选阅读)
How GPT, Claude, and Gemini are actually trained and served
Reiner Pope(对谈 Dwarkesh Patel) · MatX(CEO,前 Google TPU 架构)
用几条公式、公开的 API 价格和粉笔推断前沿实验室在做什么:每个 token 的时间 = max(访存时间, 计算时间),批大小决定成本与速度(「每 20 毫秒发一班车」);MoE 的专家并行如何铺在 72 GPU 的机架上、稀疏度受机架内存约束;流水线并行解决容量、更大的 scale-up 解决带宽;因为 RL 和推理量,模型可能比 Chinchilla 最优过度训练约 100 倍;从长上下文定价反推 KV cache 成本。
本场为长访谈,按章节节选阅读。
内容概要
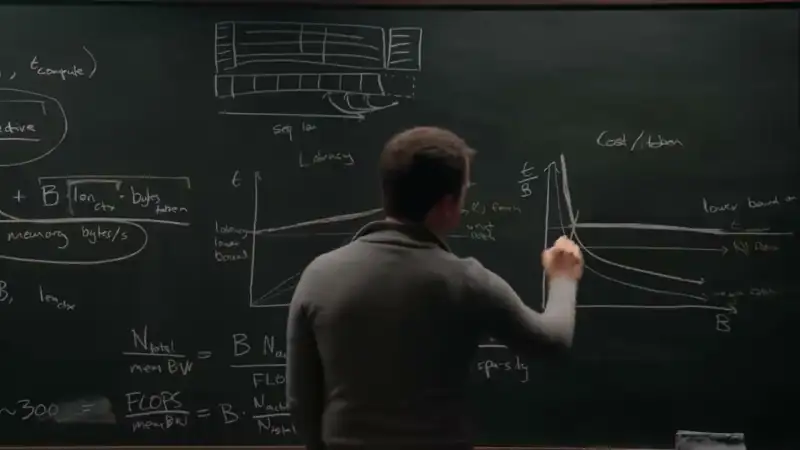
这是 2 小时 13 分钟的黑板讲座,以下基于章节、板书 OCR 与转录节选。核心方程:每个 token 的时间是访存时间(加载权重和 KV cache 的字节 ÷ 内存带宽)与计算时间(批大小 × 激活参数 × FLOPs ÷ 算力)的较大者;在平衡点上既是访存瓶颈也是计算瓶颈,是理想位置;上下文从最优的 10 万变到 20 万时,KV 读取时间增加会让系统从计算受限转为访存受限、MFU 大幅下降。批处理像列车时刻表:每 20 毫秒发一班,准备好的乘客上车,满了就等下一班——批大小决定吞吐与延迟的权衡,也解释了 API 的快/慢档定价。MoE:专家并行把不同专家放在不同 GPU 上,例如 DeepSeek 的 256 个专家放到 Blackwell 72 GPU 机架(取 64 个,每 GPU 4 个专家);跨机架通信受限,所以稀疏度受机架内存约束。GPT-4(2023 年,传言超过 1 万亿参数)之后很久才出现明显更大的模型,可能是在等内存足以容纳 5 万亿参数模型及大量序列 KV cache 的机架。流水线并行把层分布到多个机架,解决容量问题,但需要微批,无法在所有序列上摊销权重加载;Ilya 说「流水线并不明智」的背景在此。scale-up 规模变大的意义主要在于内存带宽而不是容量:带宽代际只增长 1.5–2 倍,而 scale-up 域的增长带来约 8 倍,支持更长上下文与更低延迟,对 agent 越来越重要。训练与推理的权衡:考虑到推理 token 量(他粗估每秒数亿 token)和 RL,模型可能比 Chinchilla 最优过度训练约 100 倍。从长上下文 API 价格可以反推 KV cache 的内存成本(每 token 约 2KB 的量级、KV 头数 1–8、头维度 128 等),注意力的二次项在百万 token 级才显著。最后讨论缓存的保留与取回时间平衡,以及神经网络与密码学的趋同演化。
幻灯片截图
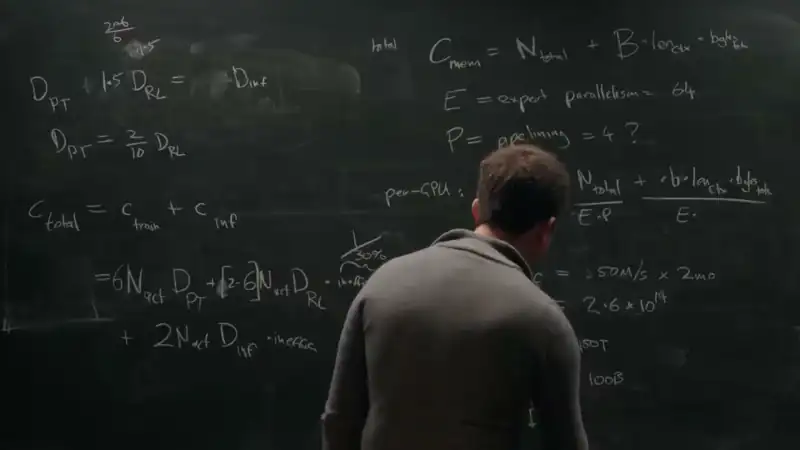
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 3:16
核心方程:每个 token 的时间 = max(访存时间, 计算时间);访存 = 权重与 KV cache 字节 ÷ 带宽,计算 = 批大小 × 激活参数 × FLOPs ÷ 算力。
- 11:09
在平衡点上同时受访存和计算限制最理想;上下文从 10 万到 20 万时 KV 读取增加,系统转为访存受限、MFU 大幅下降。
- 22:17
批处理像列车时刻表:每约 20 毫秒发一班,准备好的请求上车,满了等下一班——批大小决定成本与延迟。
- 33:27
MoE 专家并行:DeepSeek 的 256 个专家放到 72 GPU 的 Blackwell 机架(用 64 个,每 GPU 4 个专家);跨机架通信让稀疏度受机架内存约束。
- 44:35
GPT-4 后很久才出现明显更大的模型:可能是在等能放下 5 万亿参数模型及大量 KV cache 的机架。
- 55:46
流水线并行解决容量,但需要微批、无法在所有序列上摊销权重加载;更大的 scale-up 解决带宽(代际带宽只增 1.5–2 倍,scale-up 带来约 8 倍),支持长上下文与低延迟。
- 1:18:00
因为 RL 和巨大的推理量,模型可能比 Chinchilla 最优过度训练约 100 倍。
- 1:32:00
从长上下文 API 定价反推 KV cache 内存成本(每 token 约 2KB 量级);注意力的二次项在百万 token 级才变得显著。
可以用在日常工作里的
- 基础设施
自托管模型时用「访存 vs 计算」的平衡思路选批大小、上下文长度和并行方式;长上下文主要吃内存带宽。
- 模型
理解过度训练的经济学:推理量大的场景,小而训练充分的模型更划算。