AI Engineer
Rethinking Claude Code Best Practices
Lydia Hallie · Anthropic
模型变强以后,过去的「人在回路」做法要拆给模型、harness 和运行环境:auto mode 负责批准,deny 规则和沙箱负责边界,测试、hooks 和 CI 负责验收。
内容概要
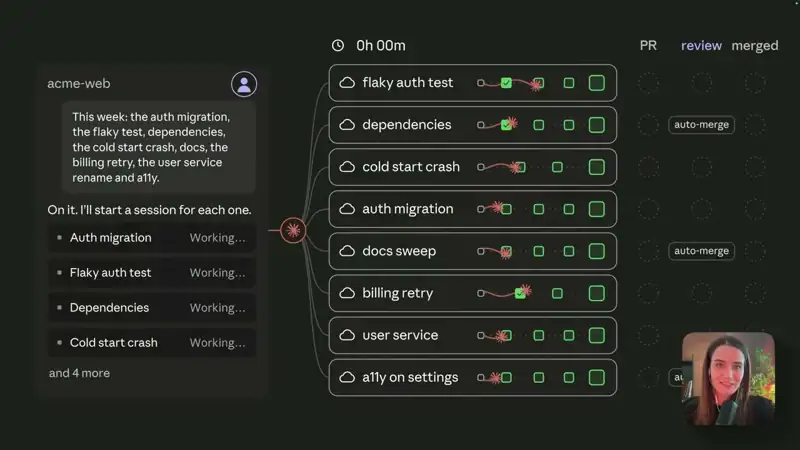
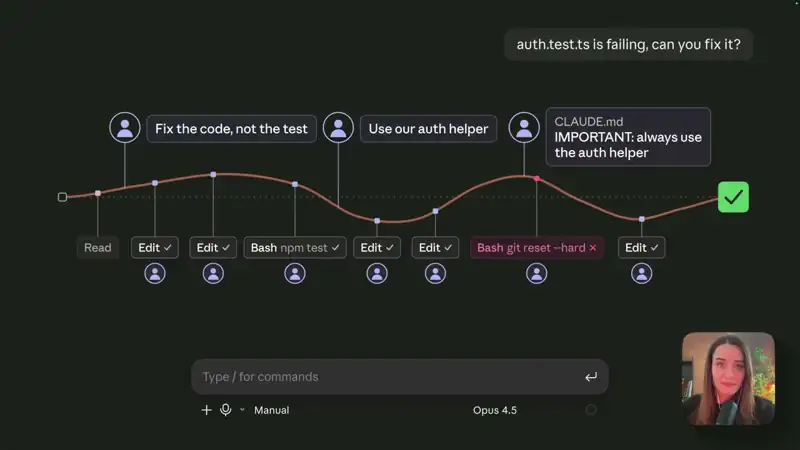
Lydia 用一次「修 auth 测试」的旧会话做对照:年初用 Opus 4.5 时,人要不停纠正、在 CLAUDE.md 里写 IMPORTANT、逐条批准命令;现在 Anthropic 内部同时跑几十个会话,几个小时不用人管,并且有会话去编排其他会话。人不在回路以后,原来人做的五件事(掌舵、批准、拒绝、验收、发起)各自交给模型、auto mode、deny 规则与环境、测试/hooks/CI,最后连发起也交给编排会话。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:43
Anthropic monorepo 每天合并的改动从 2026 年 5 月约 2,500 个涨到 9 月 3 万多个,开发者的注意力必须从「盯每一步」转到「设边界和验收点」。
- 2:39
CLAUDE.md 只写模型从代码里看不出来的东西(比如没有在代码里直接引用的遗留服务);「IMPORTANT/永远不要!」这类强调对新模型反而有害,会带来多余的工具调用。可以用 prompt 审计命令按目标模型清理 CLAUDE.md 和 skills。
- 4:48
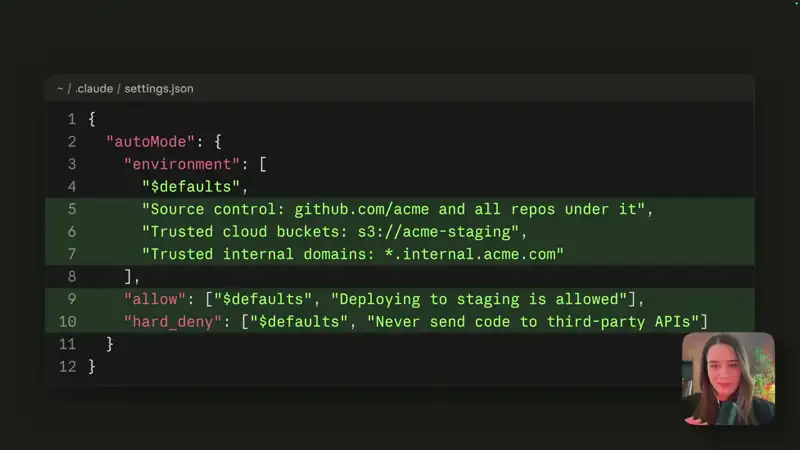
auto mode 用一个独立分类器审批读写项目以外的操作。被拦太多时,先在 settings.json 的 autoMode 里用自然语言写清可信的仓库、存储桶、内网域名,以及允许和硬禁止的事。
- 5:46
Anthropic 8 月的实验:1,053 名付费测试者,每个会话里偷换进一条危险命令,人只拦下 14%,auto mode 拦下 89%,但仍有约十分之一漏过。要「保证」只能靠 harness:deny 规则在分类器之前生效。
- 6:32
判断要不要写成规则只问一句:做错了能不能撤回?代码、测试、文档、git 能回滚的交给模型;永久删除、泄露密钥、往外发送的写成规则。
- 9:10
权限只能决定命令跑不跑,管不了命令跑起来以后碰到什么(例如 npm test 里被投毒的依赖读取 .env 和 SSH key)。所以要用沙箱让操作系统限制文件和网络;更进一步把整个会话放到云端一次性机器上,密钥用网络 secret 注入,不进入模型上下文。
- 12:06
验收点要能给出通过/失败:测试、构建、截图。提示里写清「什么算完成」,让它拆成每个任务一个测试,并要求贴出实际输出。
- 12:24
必须执行的检查放进 hooks:每次编辑跑 lint(PostToolUse),每个任务完成跑对应测试(TaskCompleted),结束前跑全量测试(Stop)。注意脚本失败要以退出码 2 结束,Claude 才会回去修。
- 14:39
每个 PR 先由一个不写代码的新上下文 Claude 评审,再由另一组 agent 逐条复核找到的 bug,只发布真实问题。人审多少按风险定:文档免审,普通改动一人,高风险两人;CI 失败自动修复,可选「检查全绿自动合并」。
- 16:06
终局是一个编排会话:它不写代码,负责拆任务、开子会话、判断回来的结果是否真的完成。编排用擅长判断的模型,执行用擅长干活的模型,可以分开设置。
可以用在日常工作里的
- 编码 Agent
清理 CLAUDE.md:删掉技术栈介绍、目录导航和全大写强调,只留代码里看不见的约束。
- 安全
按「能否撤回」划线:不可撤回的动作写 deny 规则并提交进仓库;能撤回的交给模型判断。
- 工程
把验收做成机器可判的:任务级测试 + hooks(退出码 2)+ CI 自动修复,再决定哪些类别可以自动合并。
- 基础设施
长任务放云端会话:干净仓库、受限网络、secret 注入;本地则至少给 shell 命令开沙箱。
- 团队
下一步交给 Claude 的,就是你现在仍然被卡在回路里的那一步:先挑一个比平时大得多的任务在云端跑,看它卡在哪。