AI Engineer World's Fair 2026
Field Guide to Fable
Thariq Shihipar · Anthropic · Claude Code
更强的模型需要更少的约束和更多的上下文;人的工作从「写代码」变成「找出地图与实地之间的空白」:盲点扫描、多方案原型、让模型采访你、给参考实现、记录实现笔记、最后让模型考你。
内容概要
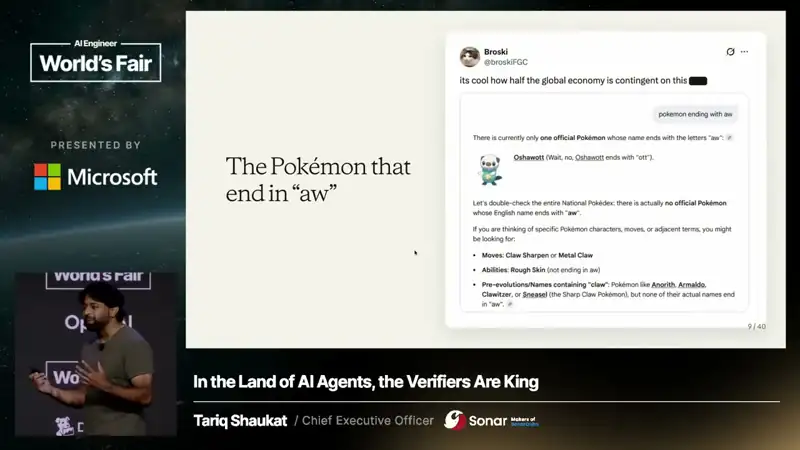
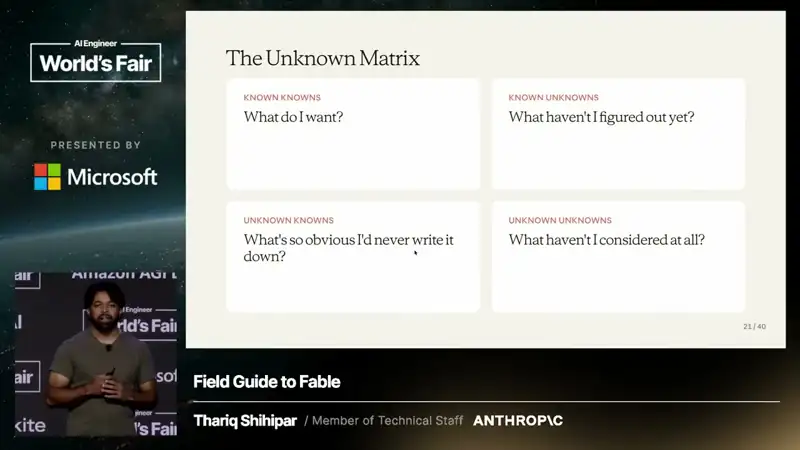
Thariq 把与 Fable 共事的心得整理成四部分:给 Claude「解束缚」、识别未知、面对编码方式改变带来的情绪、不再轻易接受旧的取舍。「能力悬空」是模型潜在能力与 harness 暴露出来的能力之间的差距:聊天模型答不好「哪些宝可梦名字以 AW 结尾」,Claude Code 会去拉全名单、写脚本过滤。Claude Code 团队刚删掉 80% 系统提示,对新模型来说例子会限制想象,应给上下文而不是一堆禁令。更强的 agent 会走进更多「地图(提示/规格)没画到的实地」,需要用已知已知/已知未知/未知已知/未知未知来分类缺口。实践方法覆盖开发全程:开工前做盲点扫描和多方案 HTML 原型、让模型围绕会改变架构的决定采访你、提供参考代码或 mockup;过程中让模型记下实现笔记;结束后让模型考你,确保你能对 PR 负责。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 3:06
能力悬空:模型的潜在能力被 harness 和提示限制。例子:聊天里很难答「哪些宝可梦名字以 AW 结尾」,Claude Code 会抓取全部名字、写脚本过滤——把回忆难题变成检索 + 脚本执行。同理,不必等上下文窗口装下整个代码库,用 bash 让它自己组装上下文。
- 5:14
Claude Code 团队删掉了 80% 的系统提示:从「小提示少工具」到「大提示大量例子」,现在又回到小提示。对新模型,例子会把解空间收窄(模型可能比例子更有想象力),应提供上下文而不是过多约束和一刀切的禁令。
- 8:33
地图与实地:地图是你脑中的提示、计划、规格,实地是真实代码库和约束;agent 每遇到一个地图没画到的决策点就是一个未知,越强的 agent 能走得越远,遇到的未知越多。
- 9:34
把缺口分成四类:已知已知(写在提示里)、已知未知(意识到但没解决)、未知已知(觉得太显然没写下的偏好)、未知未知(根本没想到)。瓶颈从产出代码变成识别 agent 无法安全推断的决定。
- 10:38
盲点扫描:接入不熟悉的认证服务前,让模型读相关模块、git diff、Slack,找常见坑和缺失知识;同样适用于学视频调色这类陌生领域。难以描述的偏好用多方案原型:让模型做一个 HTML 页面展示四种截然不同的仪表盘设计方向,用对比把隐性偏好变成明确反馈。
- 11:36
有了初步方向后,让模型采访你:提供你本人、工作和项目阶段的上下文,并要求优先问可能改变架构的问题。用参考代替纯文字规格:另一个系统或语言里的现有代码、HTML mockup 都能表达目标。
- 13:31
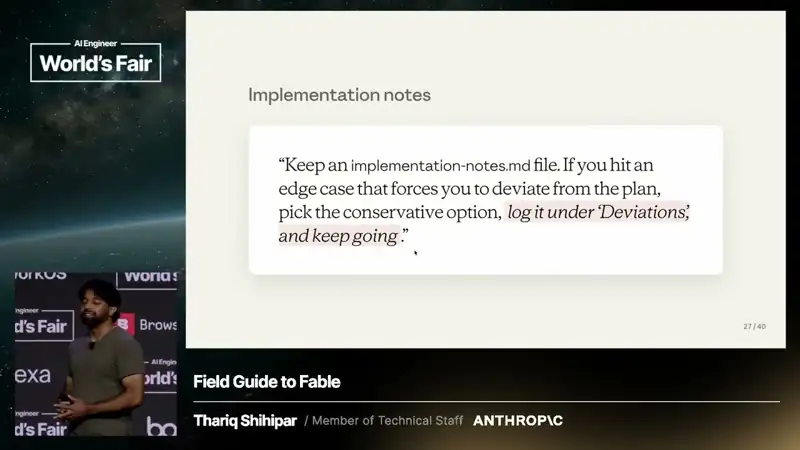
实现过程中要求 Fable 在遇到未知时写「实现笔记」,暴露偏离地图的地方和原因;完成后让模型考你发生了什么,确保你能理解并在 PR 里代表这项工作——随着 agent 更独立,人更要留在回路里。
- 14:40
他回看自己以前的创业代码库:当时要在性能和新功能之间取舍,因为实现要几个月;如今几周的活几小时就完成。他坦承对手写代码、在脑中装下整个代码库的失落。
- 15:39
「不要那么讲道理」:别马上接受熟悉的优先级取舍,试试能否同时追求多个目标,逼出真正的约束。这套幻灯片他用 Fable 约四小时做完。但「做得更容易」不等于「创造价值」,后者仍需多次尝试和判断。
可以用在日常工作里的
- 编码 Agent
给 agent 写任务时多给背景和目标,少给例子和禁令;遇到不熟悉的领域先让它做一次「盲点扫描」。
- 产品
设计决策难以描述时,让 agent 一次产出 3–4 个差异很大的 HTML 原型来对比,而不是反复用文字描述。
- 工程
把「采访我 → 给参考 → 实现笔记 → 考我」做成固定流程(可以写成 skill),用于中大型改动。
- 团队
合并前要求作者能回答 agent 出的问题,作为「理解了这次改动」的门槛。