Code with Claude 2026
Beyond the basics with Claude Code
Daisy Hollman · Anthropic(Claude Code 团队)
Claude Code 团队工程师讲「agentic 软件工程」:Claude 做不了你能做的事,就没法和你一起工作——工作散落在 Slack、仪表盘、文档里;权重冻结,只能靠上下文定制;把上下文窗口当作「打包目标」(稳定内容在前、易变内容在后,KV cache 是第二个约束);四种插件原语(skills、MCP、hooks、subagents)各自的规模化代价;用 worktree 多开 Claude、长期队友互发消息、/loop 自动照看 PR。
内容概要
Hollman 2025 年 2 月提交第一个 PR、后来全职加入 Claude Code 团队,参与了插件和 agent teams。论点:如果 Claude 不能做你能做的一切,它就不能和你一起做你的工作;开箱的 Claude Code 只看到一个仓库和一个 shell,而专业软件工程的大部分工作不在源码里——在团队聊天(分诊线程、问负责人、发 PR)、仪表盘(查错误率、确认修复上线)、设计文档和邮件里。模型权重冻结、只训练一次,你的代码库约定、机构记忆不可能训练进模型,只能用上下文学习(CLAUDE.md、skills、工具),而这些都只是文本文件,很容易起步,也很容易停在「够用」。工具:「给 agent 的红色波浪线」——用 PostToolUse hook 对 diff 跑 lint,在犯错那一刻反馈,而不是等到代码评审;区分两类工具:弥补智能不足的(死板模板、「别碰 X」的护栏,会随模型变强而过时)和随智能增长的(越强越有用)。上下文是一个盒子:系统提示、工具定义、CLAUDE.md、skills、对话(包括读过的文件、工具结果)都要装进去,留出工作空间;上下文窗口并没有真正在增长(Opus 4.7 通常是 100 万 token)。KV cache 是第二个约束:它看起来像 LRU 缓存问题但不是——稳定共享的内容放最前,易变的每任务信息放后面;缓存的 token 便宜、未缓存的贵,为了省上下文而打破缓存往往得不偿失。四种插件原语:skills(新流程)、MCP(新工具,为没有 shell 和文件系统的客户端设计)、hooks(在 Claude 的事件上运行你的代码)、agents(更多 Claude)。MCP 的规模问题:每个工具的名字、描述和 schema 都在系统提示里,20 个服务器 × 15 个工具,提示里大部分就是工具定义;工具搜索可以懒加载,但除非用户提到 Slack 这类明确名字,Claude 不一定知道要搜,Edit、Bash 这类通用工具仍需直接放入。Skills 只是文件(SKILL.md + 脚本 + fixtures),正文按需加载,但描述常驻,可靠触发通常需要一段话而不是一行。Hooks 是 shell 脚本(PreToolUse、PostToolUse、UserPromptSubmit、Stop),在上下文之外运行,10 万个 hook 里只要不触发就零 token 成本。Subagents 是有自己系统提示和工具集的命名角色,转录不回到主上下文。CLAUDE.md 不在这个列表里:每轮都为全部内容付费,哪怕 90% 与当前任务无关,而且不能组合;记忆是低质量、低成本、短期的信息。工作流的两大主题是异步和并行:worktree 至关重要(一个仓库 N 个 worktree,N 个 Claude 各在自己的分支);长期存在的队友而非一次性 subagent,SendMessage 工具让 Claude 之间按名字互发消息;/loop 定时照看 PR(每 10 分钟检查打开的 PR,修红色 CI、处理评审、落后则 rebase)。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 4:33
论点:如果 Claude 不能做你能做的一切,它就不能和你一起做你的工作;开箱的 Claude Code 只看到一个仓库和一个 shell。
- 6:50
工作真正所在的地方:团队聊天(分诊、问负责人、发 PR)、仪表盘(查错误率、确认修复上线)、设计文档、邮件——大部分不在源码里。
- 9:28
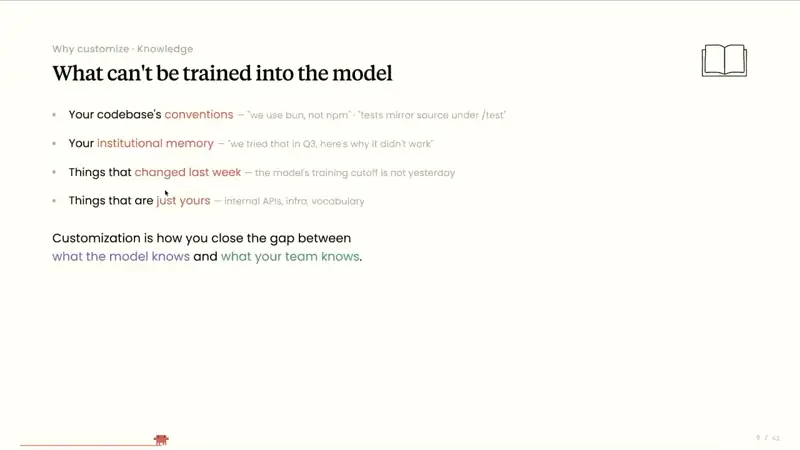
代码库约定、机构记忆不可能训练进模型:权重冻结,只能用上下文学习;CLAUDE.md、skills、工具都只是文本文件,容易起步,也容易停在「够用」。
- 13:41
「给 agent 的红色波浪线」:用 PostToolUse hook 对 diff 跑 lint 并把警告反馈回去,在犯错那一刻提醒,而不是等代码评审。
- 15:11
两类工具:弥补智能不足的(死板模板、「别碰 X」护栏)会随模型变强而过时;要优先构建随智能增长、越强越有用的工具。
- 17:28
上下文是个盒子:系统提示、工具定义、CLAUDE.md、skills、对话(含读过的文件和工具结果)都要装进去并留出工作空间;窗口并没有真正在增长。
- 19:29
KV cache 是第二个约束,不是 LRU 问题:稳定共享内容放最前、易变的任务信息放后面;缓存 token 便宜,为省上下文打破缓存往往更贵。
- 22:29
四种插件原语:skills(新流程)、MCP(新工具)、hooks(在 Claude 事件上跑你的代码)、agents(更多 Claude)。
- 25:51
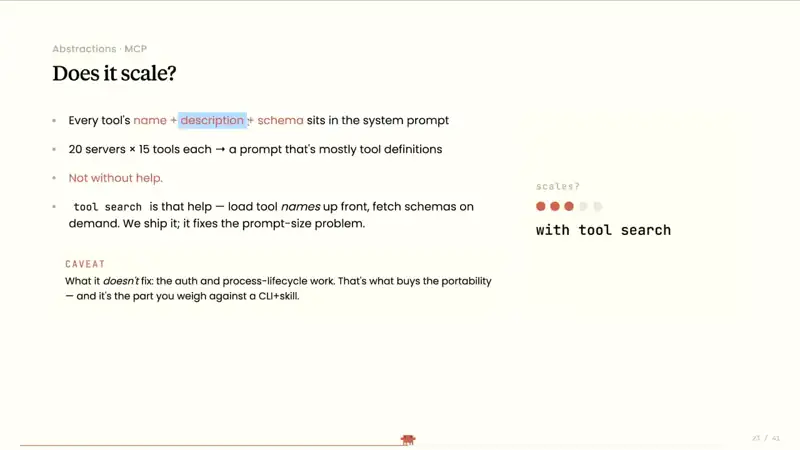
MCP 的规模问题:20 个服务器 × 15 个工具,系统提示大部分是工具定义;工具搜索可懒加载,但 Claude 未必知道要搜,通用工具仍需直接放入。
- 28:58
Skills 正文按需加载(好),但描述常驻,可靠触发往往需要一段话而不是一行。Hooks 是在上下文之外运行的 shell 脚本,不触发就零 token 成本。
- 36:19
CLAUDE.md 每轮都要为全部内容付费,即使 90% 与当前任务无关,也无法组合;记忆是低质量、低成本、短期的信息。
- 37:27
两大主题:异步与并行。worktree 至关重要:一个仓库 N 个 worktree、N 个 Claude 各在自己的分支。
- 42:28
长期存在的队友而非一次性 subagent:SendMessage 让 Claude 之间按名字互发消息——「你工作的地方之一,现在是另一个 Claude」。
- 43:46
/loop 自动照看 PR:每 10 分钟检查打开的 PR,修复红色 CI、处理评审意见、落后时 rebase。
可以用在日常工作里的
- 使用 AI 工具
把 CLAUDE.md 精简到每个任务都需要的内容,其余拆成按需加载的 skills;用 hooks 做确定性检查(lint、格式、禁止操作)。
- 使用 AI 工具
控制 MCP 服务器数量,或使用工具搜索;为常用外部系统写 skill 说明怎么用。
- 使用 AI 工具
并行开发用 git worktree,每个 Claude 一个分支;用定时 loop 处理 PR 维护。