AI Engineer World's Fair 2026
The unreasonable effectiveness of BM25 for agentic search
Jo Kristian Bergum · Hornet.dev
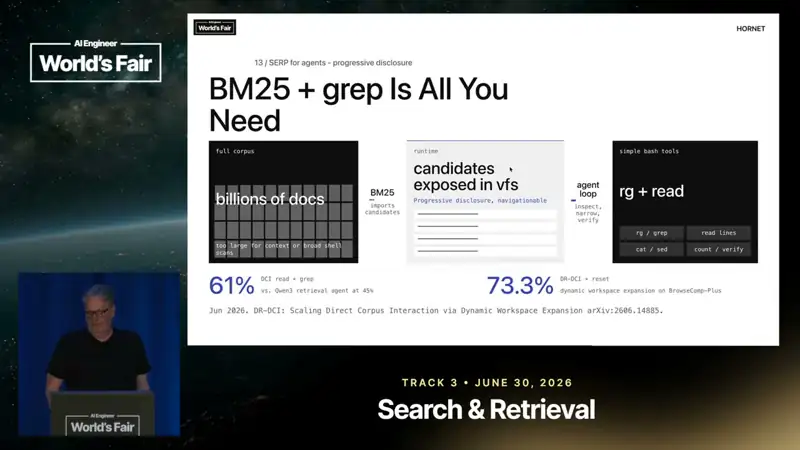
30 年历史的 BM25 在 agent 搜索里重新好用,因为「用户」变了:模型带着常识、写更长更精确的查询并反复改写;专有名词、编号这类字面匹配正是它的强项,又便宜成熟。更好的结构是「全库检索 → 文件系统工作区 → agent 用 grep/sed 选择性精读」。
内容概要
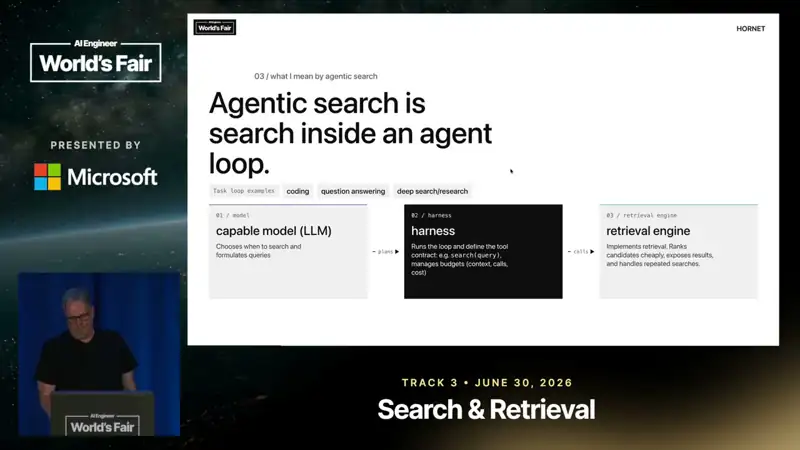
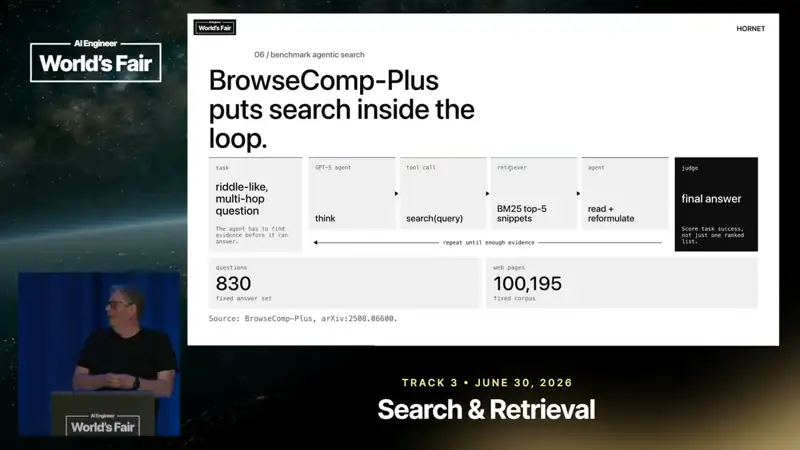
agentic 搜索 = agent 循环里的检索,需要三部分:会写查询的模型、harness、高效的检索引擎。BM25(第 25 次实验最好用而得名)给查询和文档的词项交互打分作为相关性代理;BM25 只是打分函数,不代表执行算法,不同引擎同样打分的服务成本可以差很多。BrowseComp+ 有 830 道谜语式长问题、约 10 万篇网页,模型只有一个返回片段的 Search 工具;直接把证据塞进上下文时答对率很高,说明难点在找到证据。他把上下文窗口比作软盘(约 35 万 token 后质量开始下降,个人判断)。Hornet 对比 agent 查询与 AOL 人类搜索日志:人类查询短,模型写更长的查询、用短语和 site: 等运算符。原论文里 BM25 基线的两个超参数不适合长文档,调好后答题准确率变化巨大。BM25 有用的三个理由:精确标识符(人名、邮编、SKU)、成本与成熟度(不需要约 80 亿参数的嵌入模型推理)、模型能迭代改写。Waterloo Jimmy Lin 组的「动态工作区扩展」:检索器从海量语料选文档放进文件系统工作区,模型先看标题和片段,再用 grep/ripgrep/sed/awk 选择性深读。评测应判断整条搜索轨迹并衡量服务效率。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
agentic 搜索:写代码或做深度研究的 agent 需要它没有的信息时,在循环中检索。三个部分:负责写查询的模型、harness、高效的检索引擎。
- 2:27
BM25(Best Match 25,第 25 个实验版本效果最好)按查询与文档的词项交互打分作为相关性代理;它是打分函数而非执行算法,同样打分规则的不同引擎服务成本和性能可以差很多。
- 4:53
BrowseComp+:830 道谜语式长问题、约 10 万篇网页,模型只有一个返回片段的 Search 工具。直接把证据放进上下文时答对率很高,说明主要难点是找到证据而不是使用证据。
- 6:40
上下文窗口像软盘(1.4MB):他估计模型在约 35 万 token 前后质量开始下降(个人判断),所以必须为有限的工作空间挑选有用信息。
- 8:37
Hornet 对比模型写的查询与 AOL 人类搜索日志:人类查询很短,模型写更长的查询、使用短语和 site: 等运算符——工作负载变了,基线也该变。
- 9:40
原 BrowseComp+ 研究里 BM25 的两个超参数不适合长文档;后续研究调整后整体答题准确率变化巨大。配置差的基线会扭曲检索方法之间的比较。
- 10:40
BM25 有用的三个原因:专有标识符(人名、实体、邮编、SKU)能成为精确查询词,嵌入检索较难保留这种字面区分;省去约 80 亿参数嵌入模型的推理,工具成熟;模型能迭代改写查询。
- 11:51
Waterloo Jimmy Lin 组的方法:检索器从(可能数十亿)语料中选文档放进工作区,像给 agent 的搜索结果页;工作区组织成文件系统,模型先看标题和片段再决定是否深读,用 grep、ripgrep、sed、awk 检查——利用模型在编码和 bash 上已有的训练投入。
- 14:53
传统检索评测只看排序列表;agentic 搜索应评估整条搜索轨迹(查询、改写、阅读)和服务效率(延迟、成本)。
可以用在日常工作里的
- 数据
给 agent 做检索时先上调好参数的 BM25(或混合检索)作为强基线,再决定是否需要向量检索。
- 数据
把检索结果落到文件系统工作区,让 agent 先看标题摘要、再用 grep 精读,而不是一次塞进全文。
- 评测
评估检索系统时看整条 agent 轨迹的最终答对率和成本,而不只是 top-k 召回。