AI Engineer 2026
How Revolut Cut AI Coding Costs 90% With Self-Hosted Open Models
David Abitbol · Revolut(AI 运营负责人)
Revolut 让自托管的 GLM 成为 2000 名工程师的默认编码模型:约 56 张 GPU,账单约为此前 Anthropic/OpenAI 的十分之一($0.30/百万 token、缓存命中免费);关键在为工作负载调优服务配置(首 token <3 秒、上下文长度、量化、KV cache、TP4 vs TP8),图像单独路由,并保留熟悉的 harness 与沙箱规则。
内容概要
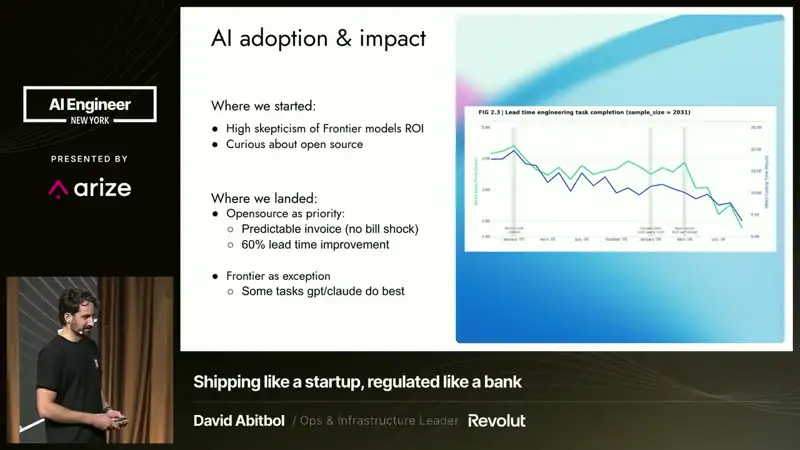
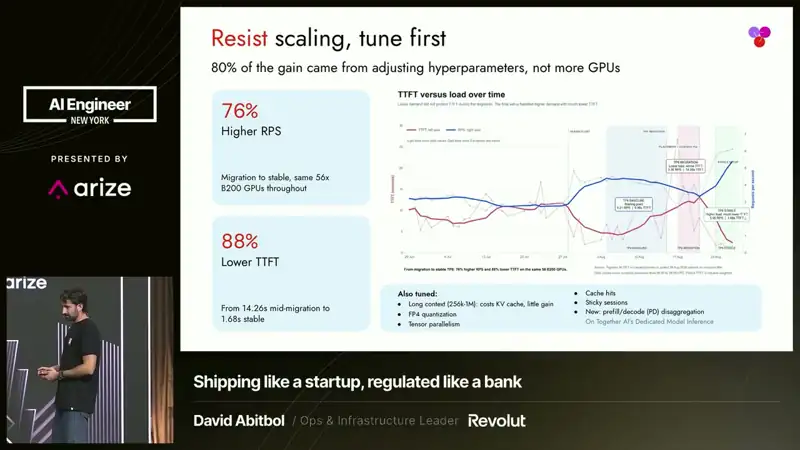
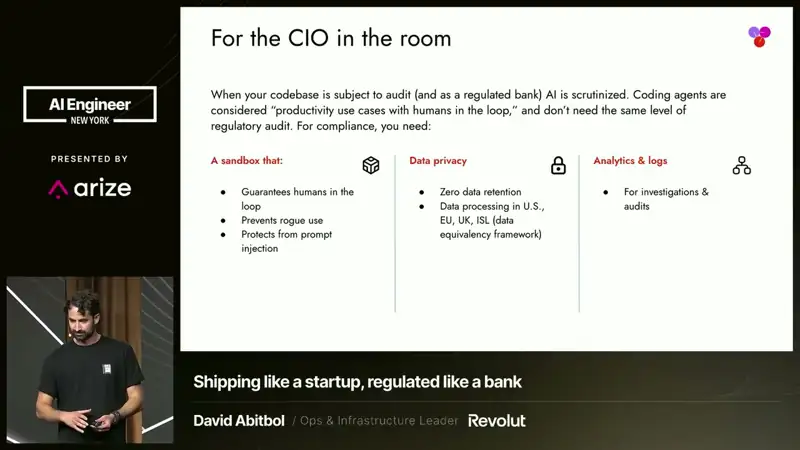
早期推广编码 agent 时,有工程师每月花一千甚至一万美元,交付收益却难以证明。Abitbol 主张衡量整个功能的旅程而不只是写代码。约从 4 月开始自托管开源模型、编码偏好 GLM,报告编码时间改善 60%、交付周期改善 70%(幻灯片标注 60%,比较口径细节不足),部分交付周期收益来自用 AI 处理邮件、Jira、Confluence。服务 2000 名工程师约需 56 张 GPU,托管一个他称约 8000 亿参数的 GLM 模型。只把权重加载到 GPU 上性能可能很差:要按工作负载调服务参数;目标首 token 小于 3 秒,约 200 token/秒就够,随需求增长在同一机群把启动延迟降到约 1.6 秒。测试团队真正需要多长上下文(256k vs 1M:更长上下文吃掉 KV cache、收益很小),量化、精度与缓存容量一起调;TP4 与 TP8 的差别在可用 KV cache;编码缓存命中目标 >90%。该 GLM 部署只支持文本,选更强的编码模型,再用本地路由把图像请求送到其他模型。给 CIO 的问题:权重来源和推理流量去向是两回事——下载中国开源模型在本地或美国托管运行,不需要把请求发往中国端点;还需要操作级沙箱规则、数据位置与保留策略、可用于事故调查的日志。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 0:12
早期推广的尴尬:有工程师每月花一千甚至一万美元,交付收益却难以证明。要衡量整个功能的旅程,而不只是编码。
- 3:08
约 4 月开始自托管开源模型,编码偏好 GLM;报告编码时间改善 60%、交付周期改善 70%。便宜的 token 让 AI 走出编辑器,用于邮件、Jira、Confluence。
- 4:25
服务 2000 名工程师约需 56 张 GPU,托管他称约 8000 亿参数的 GLM。目标:首 token 小于 3 秒,约 200 token/秒已足够。
- 5:46
只把权重装进 GPU 可能性能很差,服务设置要匹配工作负载。随需求增长,在同一机群上把首 token 延迟降到约 1.6 秒。
- 7:14
上下文、精度、缓存容量一起调:256k vs 1M 上下文——更长上下文消耗更多 KV cache、收益很小;TP4 vs TP8 的差别在可用 KV cache;编码缓存命中目标 >90%。
- 8:14
该 GLM 部署只支持文本:主编码任务选更强的模型,图像识别用本地路由送到别的模型,而不是让视觉能力决定每个请求的模型选择;保留工程师熟悉的编码 harness。
- 9:24
权重来源与推理流量去向是两回事;还要有操作级沙箱规则、有意识的数据位置与保留选择,以及事故调查用得上的日志。成本幻灯片:$0.30/百万 token、缓存命中免费,账单约为此前的十分之一。
可以用在日常工作里的
- 基础设施
团队规模的编码 agent 用量可以考虑自托管开源模型 + 路由;先按真实工作负载压测首 token 延迟和 KV cache,而不是看参数量。
- 团队
用交付周期(从需求到上线)而不只是编码速度来衡量 AI 投入的回报。