Code with Claude 2026
The prompting playbook
Margot van Laar · Anthropic(应用 AI,伦敦)
两个实战场景:修复一个在生产中堆积数月、无人负责的客服提示(先建含「对照/边界/能力边界」的测试集,再整理结构、加输出契约和停止序列、删掉为旧模型打的补丁、把计算交给工具、给升级规则「两面的代价」);以及从零构建排班 agent(简单提示 → 更大模型 → 自适应思考 → 生成—评估—修复循环)。
内容概要
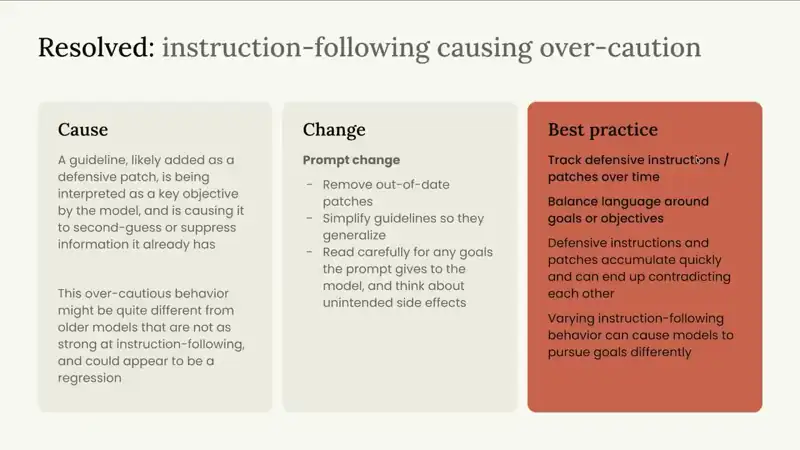
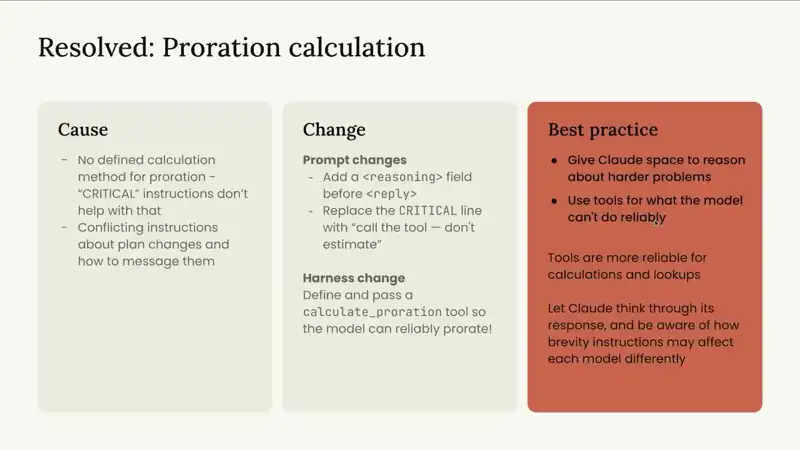
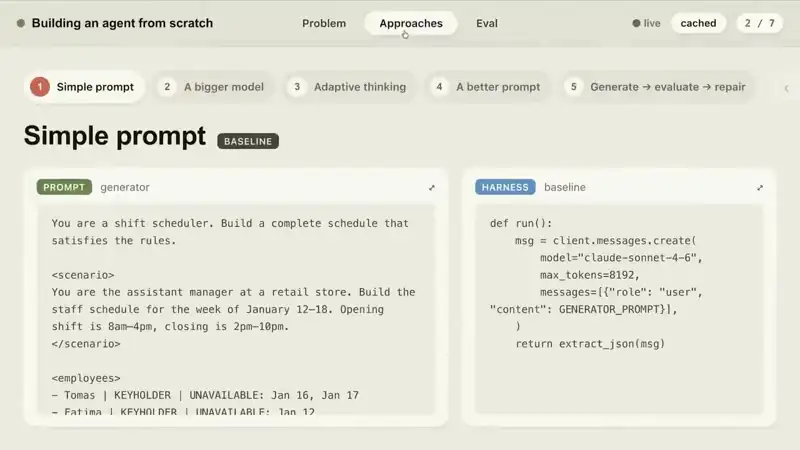
van Laar 认为提示仍是构建 AI 系统最关键的技能之一。场景一:一个在生产中累积数月的大而乱的提示,没有明确负责人,混杂政策文档、语气规则、流程步骤。先定义评测集(Meridian Mobile 客服 bot),覆盖三类:对照用例(应该总是通过)、边界用例(曾经失败过、加了指令防止复发的)、能力边界(何时转人工或直接拒绝)。每个用例跑 6 次。清理:提示告诉 bot「你是人类」——不对;有从网站直接复制来的内容(提到首图、cookie 提示);所有指令挤成一段。Prompting 101:明确角色和任务、加结构(XML 标签)、去冗余。输出契约:给出输出骨架(如 <reply> 标签)和停止序列,复杂结构用 structured outputs。热点数据问题:失败来自为旧模型打的防御性补丁——用版本控制记录每个防御性修改的原因,以便回溯。按比例计费(proration):提示里没有定义计算方法,写「CRITICAL」没有用,还有关于套餐变更的相互冲突的指令——把计算交给工具实现。升级逻辑:原提示只说「除非绝对必要否则不要转人工,每次约 8 美元且影响团队指标」,只给了一面的代价,模型会过度避免升级,且与评测期望冲突——要给两面:升级花 8 美元,但处理错了的代价更高。场景二:从零构建排班 agent(每个班至少一名钥匙持有人、不在员工不可用的日子排班、不安排重叠班次等):带结构和 JSON 输出格式的简单提示 + Sonnet 4.6 初次全部失败;换更大模型、开自适应思考可以全过,但 token 和延迟更高;最终用生成—评估—修复循环:生成初稿 → 另一个提示逐条规则检查并给出每个违规的证据 → 修复提示根据违规修改。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:52
要修的提示:在生产中堆积数月、无明确负责人,混杂政策文档、语气规则和流程步骤。
- 4:13
评测集三类用例:对照(应该总是通过)、边界(曾失败过的)、能力边界(何时转人工或拒绝);每个用例跑 6 次。
- 8:29
清理:删掉「你是人类」这类错误设定、从网页复制来的冗余(首图、cookie 提示),把挤成一段的指令按角色、任务、规则用 XML 结构化。
- 12:00
输出契约:给出输出骨架(<reply> 标签)+ 停止序列;复杂结构用 structured outputs 保证一致性。
- 16:59
失败来自为旧模型打的防御性补丁:用版本控制记录每次防御性修改的原因,未来可以回溯。
- 20:00
按比例计费算错:提示里没定义计算方法,写「CRITICAL」无济于事,且指令互相冲突——把计算交给工具实现。
- 21:14
升级逻辑:只告诉模型「转人工每次 8 美元」会让它过度回避升级;要给两面:升级有成本,处理错了代价更高。
- 25:17
从零构建排班 agent:简单提示 + Sonnet 4.6 全部失败;更大模型或自适应思考能通过但更贵更慢。
- 29:35
生成—评估—修复循环:生成初稿 → 另一个提示逐条规则检查并给出违规证据 → 修复提示按违规修改。
可以用在日常工作里的
- 评测
改提示前先建测试集(对照 + 曾经的失败 + 能力边界),每个用例多次运行。
- 使用 AI 工具
提示词放进版本控制并注明每条防御性规则的原因;确定性计算交给工具。
- agent
约束多的生成任务用「生成—评估—修复」三段式,而不是单靠更大的模型。