YC Startup School 2026
This is the State of the Art in Robotics
Chelsea Finn · Physical Intelligence(联合创始人)/ Stanford
机器人已经能叠衣服、做咖啡、收拾厨房,难点是长时间可靠、无人照看。Physical Intelligence 的答案:从经验中学习的 RL(人类介入纠正死路、通用价值函数跨任务摊销),把吞吐量提高约 2 倍、连续 13 小时做拿铁;多尺度记忆支撑长任务;π0.7 用所有多样数据和详细多模态提示训练单一模型,超过微调的专家模型并出现组合泛化——机器人的「GPT 时代」。
内容概要
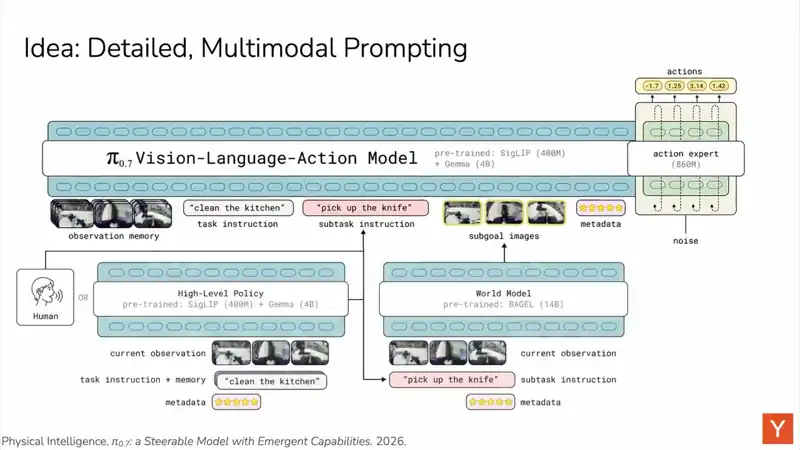
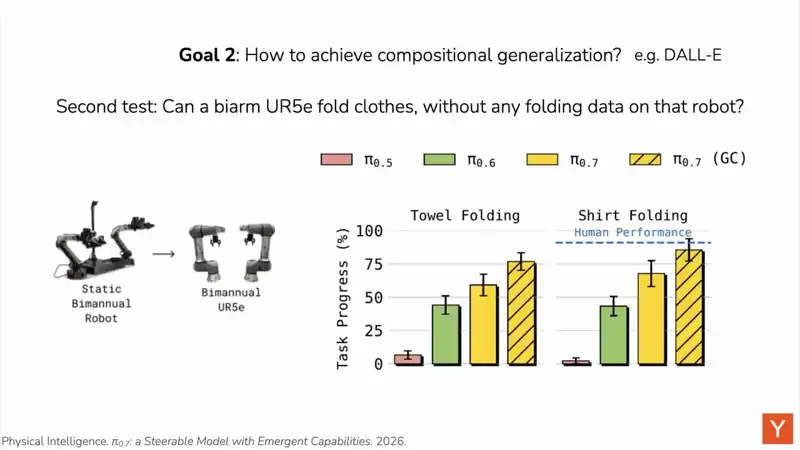
Finn 两年前创立 Physical Intelligence,目标是让任何机器人在真实世界做任何任务;一年前展示了叠衣服和在陌生房间完成任务,此后又做到了更多。可用的难点在可靠性:例如做浓缩咖啡需要精确而有力地插入冲煮手柄、平稳端起有液体的杯子、准确掌握时机,还要可靠到不必频繁照看。RL 配方:PPO/GRPO 已在 LLM 上规模化,但物理世界有两大低效——在死路轨迹上浪费时间(机器人同时抓起两个贴在一起的纸箱还继续折),解决办法是人类遥操作介入示范如何恢复,或提前终止;对单个提示多次采样来估值太贵,改为在不同提示间摊销,训练一个通用价值函数,从大量机器人经验视频中学会什么是进展(如不小心把衬衫展开是负进展),同一个价值函数可用于从冰箱取物等完全不同的场景。成果(π*0.6,「从经验中学习的 VLA」):与人协作做拿铁、连续运行 13 小时;在 Dandelion 巧克力工厂做折箱、贴标签、堆叠的真实流程;在陌生家庭叠没见过的衣服;用吞吐量(成功率与速度的结合)衡量,RL 带来约 2 倍提升。记忆:多数前沿机器人基础模型没有记忆或上下文,只看当前传感器读数;短技能和重复任务可以,但多步长任务需要记忆来追踪进度——多尺度具身记忆(例如「我已经用海绵擦过台面、用纸巾擦干、扔掉了纸巾」)。通用化:类比通用 AI 的历史——三年前机器人还普遍为每个项目从零采集数据集,就像每次从零采集 ImageNet;目标一是从「微调专家」走向开箱即用(BERT → GPT),目标二是组合泛化(像 DALL-E)。做法:详细的多模态提示(子任务指令、世界模型生成的子目标图像)+ 在所有多样数据上训练单一模型 π0.7:叠有领衬衫、拧螺丝等精密装配;开箱的预训练模型与微调专家相当甚至更好,在没有机器人专门叠衣数据时接近人类遥操作水平;能操作空气炸锅这类罕见电器。消融:去掉最多样的数据,保留任务性能大幅下降;随机去掉 20% 较不多样的数据只轻微下降——多样性最关键。问答:小团队可以直接从开源通用策略(π0、π0.5)开始微调;未来训练数据中会有大量机器人自主尝试的经验,以及人类视频和网页数据。
幻灯片截图
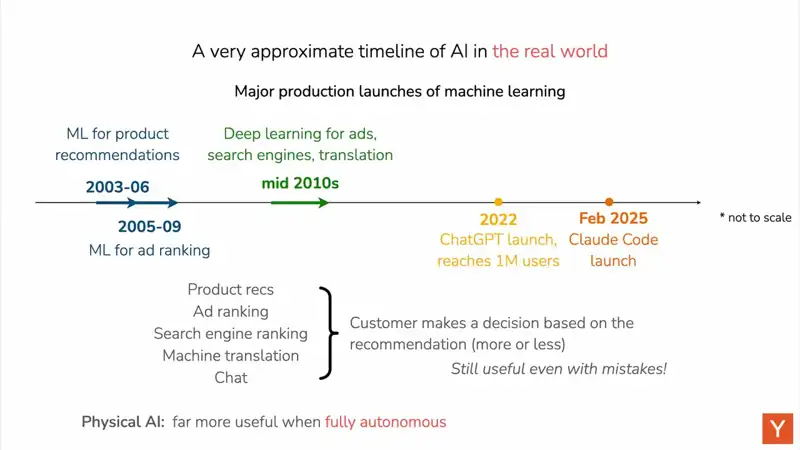
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 1:23
机器人已能叠衣服、做咖啡、收拾厨房、组装;更难的是长时间可靠、不需要人照看。
- 5:49
可用性来自可靠性:做浓缩咖啡要精确有力地插入冲煮手柄、平稳端杯、准确掌握时机,还要可靠到不用频繁照看。
- 9:43
物理世界 RL 的低效一:在死路轨迹上浪费时间(同时抓起两个纸箱还继续折)——由人遥操作介入示范恢复,或提前终止。
- 11:00
低效二:对单个提示多次采样估值太贵——在不同提示间摊销,训练通用价值函数识别进展(把衬衫弄乱是负进展),可迁移到从冰箱取物等不同场景。
- 14:20
π*0.6:连续 13 小时做拿铁;在 Dandelion 巧克力工厂完成折箱、贴标签、堆叠的真实流程;在陌生家庭叠没见过的衣服;RL 让吞吐量提高约 2 倍。
- 17:32
大多数前沿机器人基础模型没有记忆或上下文;多步长任务需要多尺度具身记忆来追踪已完成的步骤。
- 23:21
三年前机器人项目还普遍从零采集专用数据集训练——就像每次从零采集 ImageNet;目标是开箱即用(BERT → GPT)和组合泛化(如 DALL-E)。
- 28:28
π0.7:详细多模态提示(子任务指令 + 世界模型生成的子目标图像)+ 在所有多样数据上训练单一模型;开箱即可媲美甚至超过微调专家,能操作空气炸锅等罕见电器。
- 34:58
消融:去掉最多样的数据,保留任务性能大幅下降;随机去掉 20% 较不多样的数据只轻微下降——数据多样性最关键。
- 40:48
小团队可以直接从开源通用策略(π0、π0.5)开始微调;未来训练数据中大量会是机器人自主尝试的经验。
可以用在日常工作里的
- 机器人
做机器人产品时以「吞吐量」(成功率 × 速度)和长时间无人值守运行来衡量,而不是演示视频。
- 机器人
从开源通用策略微调起步;采集数据时优先多样性而不是同一场景的重复次数。