Sequoia AI Ascent 2026
Robotics' End Game
Jim Fan · NVIDIA(具身自主研究组 GEAR)
「大平行」:机器人照抄 LLM 的路线——世界模型预训练(预测下一个物理世界状态)→ 动作微调 → 物理 RL;视频模型在规模上自发学到重力、浮力、光照,VLA 让位于「世界动作模型」(DreamZero);遥操作让位于第一人称人类数据(EgoScale:2.1 万小时人类视频 + 4 小时遥操作);「算力 = 环境 = 数据」。
内容概要
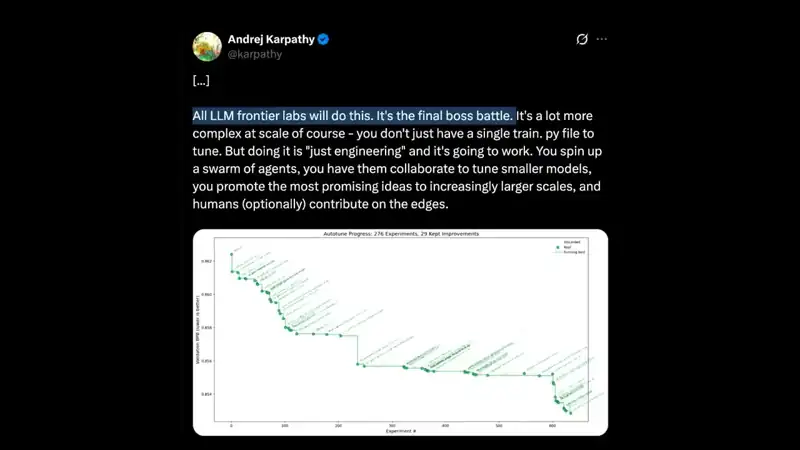
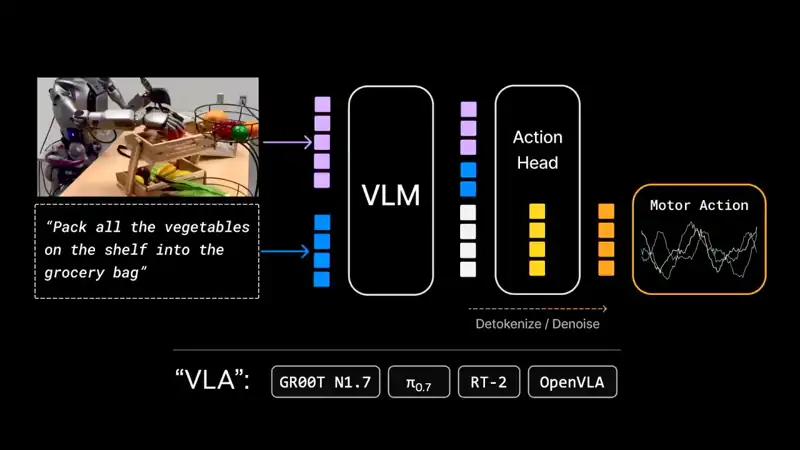
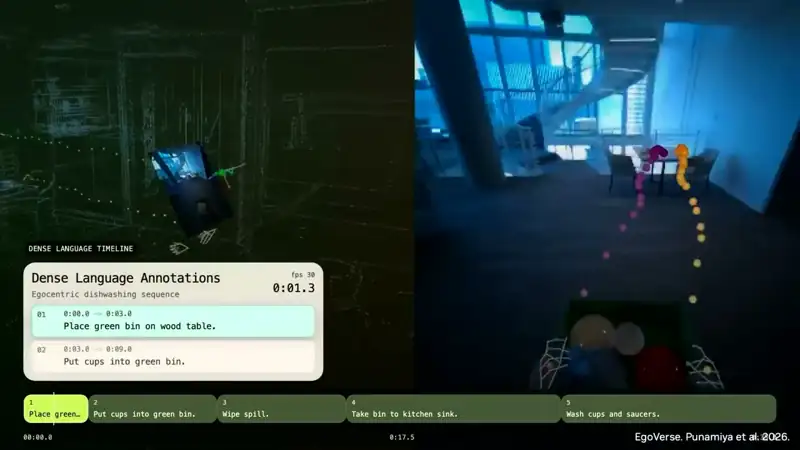
Fan 从 2016 年黄仁勋把第一台 DGX-1 送到 OpenAI 讲起:LLM 已进入「终局」,机器人也可以抄作业——「大平行」:LLM 是预训练(模拟字符串)→ SFT(对齐)→ 推理 RL(超越);机器人对应世界建模(模拟下一个物理世界状态)→ 动作微调(对齐到真实机器人重要的那一小片)→ 物理 RL 走完最后一英里。为什么 VLA 不够:RT-2 这类视觉-语言-动作模型的视觉和动作不是一等公民。第二种预训练范式竟是「AI 视频垃圾」:Veo 3 等视频模型在预测下一团像素时自发学到重力、浮力、光照、反射、折射,甚至通过在像素里向前模拟来解迷宫。DreamZero:视频预测对了动作就对,视频幻觉动作就失败;在实验室随便输入提示词,它像 GPT-2 一样努力把动作形状做对(与人握手、解鞋带等未见任务)——他称之为世界动作模型(WAM),「VLA 安息」。数据:Generalist 的可穿戴夹爪、Sunday 的三指数据手套各催生了独角兽;NVIDIA 的 DexUMI 外骨骼与五指灵巧手一一映射,比遥操作更快、成功率更高。EgoScale:用 2.1 万小时野外第一人称人类数据(零机器人数据)预训练,预测手部关节和腕部姿态,再用 50 小时高精度动捕手套数据和 4 小时遥操作(不到训练数据的 0.1%)做动作微调,端到端从相机像素到 22 自由度灵巧手,完成分卡片、操作注射器转移液体等任务;人类验证损失随数据量(1k→20k 小时)呈扩展规律。「遥操作安息,传感化人类数据万岁」。环境:前沿实验室花大钱买数百万个编码 RL 环境,机器人也急需扩展环境;真实机器人上的 RL 可把某些任务推到接近 100% 成功率、连续运行数小时;DreamDojo 是纯数据驱动的世界模型,实时输出下一帧画面和传感器状态,没有物理方程和图形引擎。新的后训练范式:少量真实机器人工作站 + 跑世界模拟的图形核心 + 跑世界模型的推理算力——算力 = 环境 = 数据(「买得越多省得越多」)。技术树:物理 API、黑灯工厂(输入 Markdown 设计,输出组装好的产品)、自动化湿实验室、最终是「物理自动研究」——机器人设计、改进、建造下一代自己;从 2012 年 AlexNet 到 2026 年用了 14 年,再加 14 年是 2040 年。他认为两三年内会通过「物理图灵测试」。
幻灯片截图
截图来自原视频,仅用于评论与学习。
要点(点击时间跳到原视频)
- 2:17
「大平行」:LLM 是预训练→SFT→推理 RL;机器人对应世界建模(预测下一个物理状态)→ 动作微调 → 物理 RL。
- 3:39
VLA(如 RT-2)的问题:视觉与动作不是一等公民。
- 4:32
视频模型(如 Veo 3)在规模上预测像素,自发学到重力、浮力、光照、反射、折射,甚至通过在像素中向前模拟来解迷宫。
- 6:49
DreamZero 世界动作模型(WAM):视频预测对了动作就对;对未见任务(握手、解鞋带)像 GPT-2 一样把动作形状做对——「VLA 安息」。
- 9:05
数据采集:Generalist 的可穿戴夹爪、Sunday 的数据手套;NVIDIA DexUMI 外骨骼与五指灵巧手一一映射,比遥操作更快、成功率更高。
- 11:26
EgoScale:2.1 万小时第一人称人类数据(零机器人数据)预训练 + 50 小时动捕手套 + 4 小时遥操作(<0.1%),端到端控制 22 自由度灵巧手;人类验证损失随数据量呈扩展规律。
- 13:40
「遥操作安息,传感化人类数据万岁」;机器人也需要像编码 RL 那样大规模扩展环境,真实机器人 RL 可把任务推到接近 100% 成功率。
- 15:55
DreamDojo:纯数据驱动的世界模型,实时输出下一帧画面与传感器状态,没有物理方程和图形引擎;后训练 = 少量真实工作站 + 世界模拟 + 世界模型推理——「算力 = 环境 = 数据」。
- 17:52
技术树:物理 API、黑灯工厂(输入 Markdown 设计、输出成品)、自动化湿实验室、物理自动研究;2012→2026 用了 14 年,再加 14 年到 2040。
可以用在日常工作里的
- 机器人
关注世界模型 + 第一人称人类数据这条路线:数据采集硬件(手套、外骨骼)可能比遥操作更具扩展性。
- 机器人
机器人 RL 的瓶颈是环境,世界模型可以充当可扩展的模拟环境。